The Pulse
Google porta Gemini 4 Argon nei flussi di lavoro della robotica
Google presenta Gemini 4 Argon con esempi di robotica che riguardano il controllo dei robot, la simulazione e l’analisi di compiti fisici. Le dimostrazioni riportano risultati specifici, ma si basano su configurazioni robotiche definite, st
AI.info Team · Scritto con l’IA ·
Google afferma che Gemini 4 Argon può aiutare i robot a svolgere compiti che vanno dalla creazione di simulazioni alla manipolazione fisica. Gli esempi pubblicati dall’azienda il 13 ottobre, però, dipendono da interfacce robotiche definite con precisione e da software di simulazione: non mostrano Argon all’opera come controller robotico autonomo.
«Usando soltanto il ragionamento, Argon ottiene un punteggio dell’87%, superando ogni altro modello di frontiera».
Scrive Kanishka Rao, ingegnere software principale di Google, sul Google Developers Blog.
Nel suo articolo, Rao presenta Argon come un modello generalista per l’intero ciclo di sviluppo della robotica e afferma che è primo nel benchmark Embodied Reasoning Question Answer (ERQA). Il punteggio è dichiarato da Google; l’annuncio non fornisce una ripartizione dei risultati specifica per Argon né descrive nel dettaglio il metodo di valutazione.
Dalle immagini delle telecamere ai comandi per i robot
Le dimostrazioni di Google coprono quattro ambiti: il controllo dei robot, la conversione di scene del mondo reale in simulazioni, l’interpretazione di attività fisiche nei video e il miglioramento delle azioni dei robot attraverso simulazioni e prove su hardware. La varietà è il punto centrale: Argon non viene presentato come un modello specializzato nel movimento, ma come un modello di ragionamento capace di scrivere codice e lavorare con informazioni visive e spaziali.
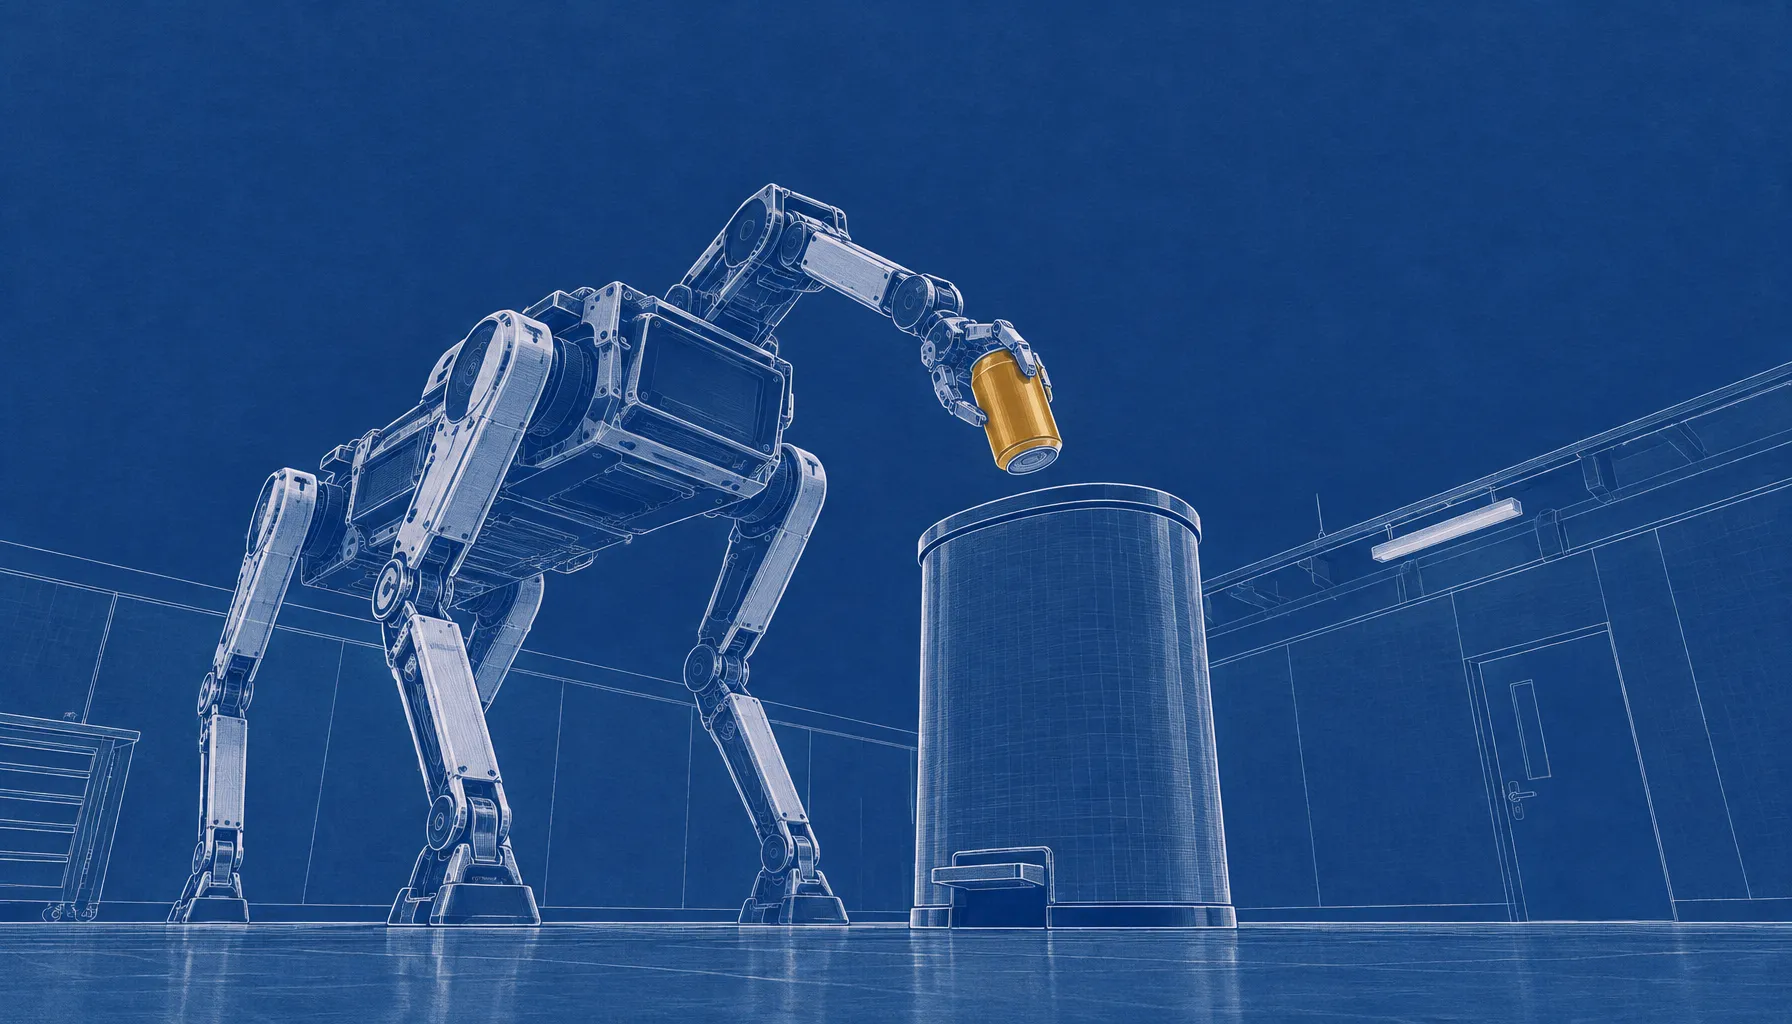
In un esempio, Argon guida un robot quadrupede Boston Dynamics Spot dotato di un braccio a sei gradi di libertà in un compito che prevede l’uso di un bidone con apertura a pedale. Crea un gemello digitale in MuJoCo per esercitarsi nel movimento, poi controlla le immagini delle telecamere per verificare la posizione del piede del robot sul pedale e l’allineamento della mano sopra il bidone. In un altro esempio, Argon rimette in posizione una tazza caduta e vi inserisce un tovagliolo, usando coordinate calibrate delle telecamere e una serie di comandi di movimento forniti.
Questi dettagli mostrano anche che cosa richiedono le dimostrazioni oltre al modello. Il compito della tazza prevede un sistema di coordinate visive, movimenti predefiniti e un ciclo di feedback; l’esempio con Spot usa una capacità specifica del robot e un simulatore fisico. Google descrive gli scenari come prompt rappresentativi, non come un controller generalista collegabile a qualsiasi robot senza ulteriore lavoro di ingegneria.
I risultati delle simulazioni sono accompagnati da un dato sull’hardware
Google afferma che Argon può trasformare un’unica immagine di un piano di lavoro in un ambiente MuJoCo calibrato, generare più di 4.500 episodi di simulazione randomizzati e usarli per migliorare un modello visione-linguaggio-azione. Per una valutazione, l’azienda riferisce che la percentuale di successo su un robot reale è salita dal 56% al 75%, mentre il tempo necessario a completare il compito è sceso da 35 a 24 secondi.
Il prompt della valutazione specifica uno spazio di lavoro bimanuale con due bracci Franka FR3 a 7-DoF, pinze a ganasce parallele e quattro telecamere RGB. Google presenta i dati come un esempio di miglioramento ottenuto tramite simulazione: non vanno quindi interpretati come una misura generale delle prestazioni di Argon su robot o compiti diversi.
Il link di Google a ERQA rimanda a un repository pubblico del benchmark che descrive 400 domande multimodali a scelta multipla sul ragionamento spaziale e su scenari del mondo reale. Il benchmark verifica il ragionamento incarnato sotto forma di domande e risposte: è cosa diversa dal misurare con quale affidabilità un robot porta a termine compiti fisici. Il risultato dell’87% nel benchmark e l’esempio su hardware citati nell’annuncio riguardano quindi capacità diverse.
L’API non è un’interfaccia diretta per i robot
Gli sviluppatori possono usare il modello con ID gemini-4-argon tramite il livello a pagamento della Gemini API in AI Studio. La documentazione dell’API di Google elenca testo, immagini, video, audio e PDF come input, con output testuale, e indica che la Live API non è supportata. Le dimostrazioni, tuttavia, usano cicli iterativi di feedback con il modello: chi sviluppa un’applicazione deve predisporre l’infrastruttura che raccoglie le osservazioni, le invia al modello e traduce in sicurezza le risposte in azioni del robot.
L’articolo pubblicato da Google il 13 ottobre sostiene un ampio ruolo di Argon nello sviluppo della robotica; gli esempi concreti mostrano quanto questa prospettiva dipenda ancora da simulazioni, sensori calibrati e software di controllo specifico per ciascun compito.