Ricerca
WorldCrafter: modello video del mondo coerente con memoria implicita consapevole del 3D
I modelli video del mondo consentono di esplorare in modo interattivo ambienti dinamici, ma faticano a tenere conto delle osservazioni precedenti su orizzonti temporali lunghi e da diversi punti di vi
- arXiv
- 2609.24984
- Pubblicato
- 2026-09-21
- Autori
- Wangbo Yu, Kunhao Liu, Wenbo Hu, Shenghai Yuan, Chaoran Feng, Haiyang Zhou, Yukun Huang, Yiran Wang, Wang Zhao, Yingmin Luo, Ying Shan
Abstract degli autori
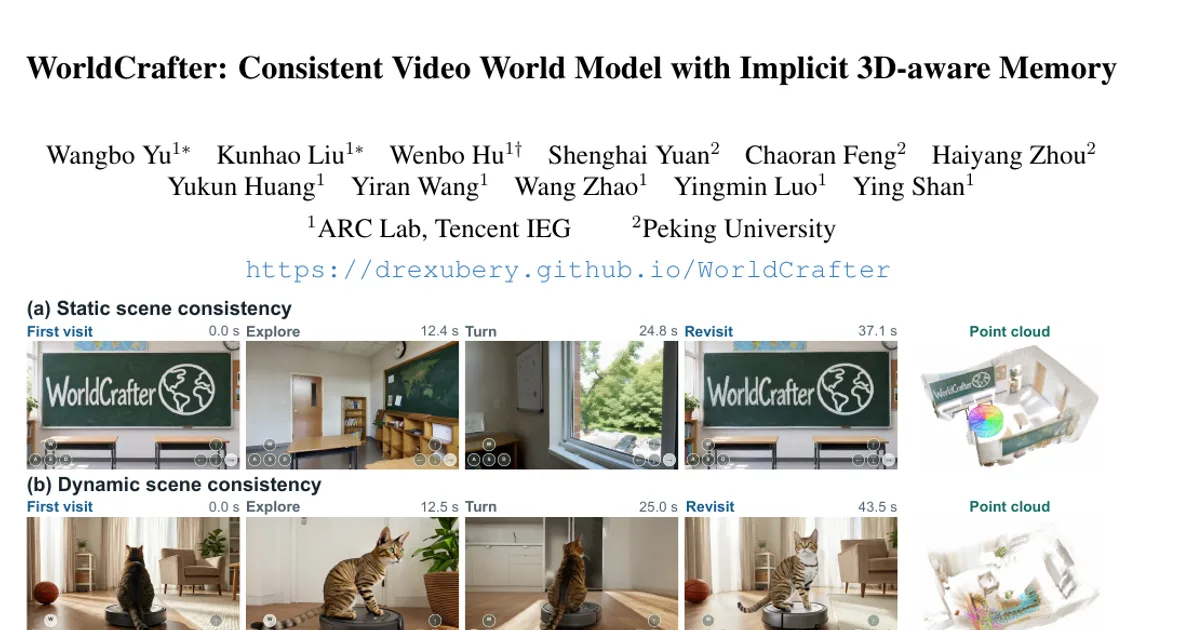
I modelli video del mondo consentono di esplorare in modo interattivo ambienti dinamici, ma faticano a tenere conto delle osservazioni precedenti su orizzonti temporali lunghi e da diversi punti di vista. Presentiamo WorldCrafter, un modello video del mondo che apprende una memoria implicita consapevole del 3D, interrogabile tramite la camera. L’idea centrale è lasciare che il punto di vista richiesto determini come comprimere le informazioni raccolte da più viste entro il budget limitato di token del generatore video. Addestrati congiuntamente al generatore video, un encoder della memoria e un modulo di lettura condizionato dalla posa integrano le osservazioni passate in un insieme fisso di token specifici per la vista di destinazione prima della fase di denoising, senza ricorrere a corrispondenze esplicite basate sulla profondità. Combinando questa memoria con il contesto temporale recente e la distillazione in pochi passaggi, WorldCrafter consente di esplorare scene in streaming partendo da una singola immagine in ingresso o da un prompt testuale. Gli esperimenti condotti su scene statiche e dinamiche mostrano notevoli miglioramenti nella coerenza su orizzonti temporali lunghi e nella precisione del controllo della camera, mantenendo al contempo la qualità visiva durante esplorazioni della durata di minuti.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv