Ricerca
VIS-Ground: narrazione video interattiva con ancoraggio contestuale
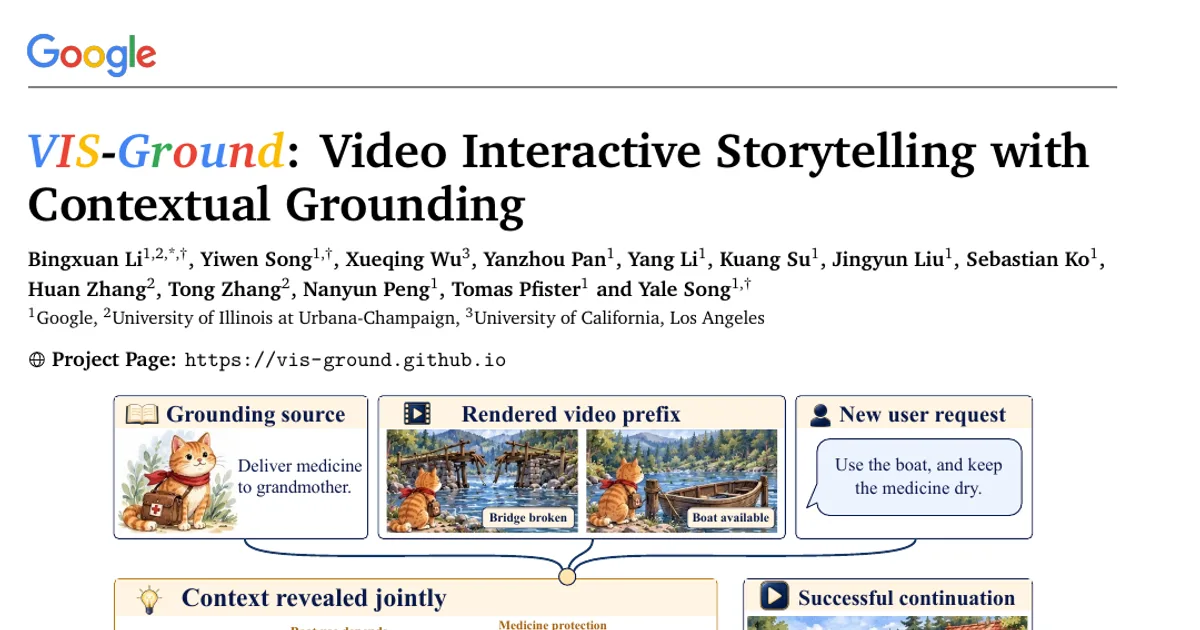
La narrazione video interattiva consente agli spettatori di orientare attivamente lo sviluppo di un video. Quando però possono intervenire durante la generazione, emerge una nuova difficoltà: la richi
- arXiv
- 2610.09326
- Pubblicato
- 2026-10-07
- Autori
- Bingxuan Li, Yiwen Song, Xueqing Wu, Yanzhou Pan, Yang Li, Kuang Su, Jingyun Liu, Sebastian Ko, Huan Zhang, Tong Zhang, Nanyun Peng, Tomas Pfister, Yale Song
Abstract degli autori
La narrazione video interattiva consente agli spettatori di orientare attivamente lo sviluppo di un video. Quando però possono intervenire durante la generazione, emerge una nuova difficoltà: la richiesta di uno spettatore può dipendere, in modo implicito, sia dalla fonte di riferimento sia dallo stato attuale del video già prodotto. Queste dipendenze potrebbero non essere esplicitate in nessuno dei singoli input e manifestarsi solo considerando insieme la fonte, il video prodotto fino a quel momento e la nuova intenzione dello spettatore. I sistemi esistenti di generazione video interattiva si concentrano soprattutto sul rispetto delle istruzioni degli spettatori, mentre i metodi di generazione video ancorata a una fonte puntano ad allineare i contenuti generati a una narrazione o a una fonte di conoscenza esterna. Resta così poco esplorata una questione fondamentale: su quale contesto deve basarsi un modello di generazione quando prosegue un video in modo interattivo, e come si possono trasformare input eterogenei e non strutturati in tale contesto di riferimento? In questo lavoro definiamo l’ancoraggio contestuale come il processo che trasforma un contesto di input eterogeneo in un modello eseguibile di vincoli per la generazione video. Per affrontare questa sfida, presentiamo VIS-Ground, che esegue un’astrazione strutturata del contesto per ricostruire gli stati ancorati alla fonte e le dipendenze tra contesti, induce vincoli di generazione per tradurre le dipendenze pertinenti in vincoli specifici per ciascun candidato e genera video soggetti a tali vincoli attraverso pianificazione, verifica, revisione e rendering. Su tre architetture di base per la generazione video, VIS-Ground ottiene sistematicamente il punteggio composito complessivo più alto, con un miglioramento assoluto medio di 10,3 punti rispetto ai migliori sistemi di riferimento per ciascuna architettura. Un’analisi dettagliata mostra inoltre miglioramenti nell’ancoraggio sia alla narrazione sia alle conoscenze e mette in luce le sfide ancora aperte nell’estrazione delle dipendenze e nella loro fedele realizzazione durante il rendering video.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv