Ricerca
Agenti linguistici senza stato: come scalare la ricerca automatizzata su orizzonti lunghi
I sistemi di ricerca automatizzata impiegano sempre più spesso agenti basati su LLM per periodi prolungati, ma aumentare il calcolo in fase di inferenza non produce di per sé maggiori progressi: gli a
- arXiv
- 2610.07625
- Pubblicato
- 2026-10-06
- Autori
- Qizheng Zhang, Changxiu Ji, Isaac Sun, Yuetai Li, Shubhangi Upasani, Sherry Ruan, Boyuan Ma, Fenglu Hong, Vamsidhar Kamanuru, Yoonho Lee, Yuzhen Mao, Genghan Zhang, Rulin Shao, Qiuyang Mang, Andy Dimnaku, Changran Hu, Radha Poovendran, Kunle Olukotun
Abstract degli autori
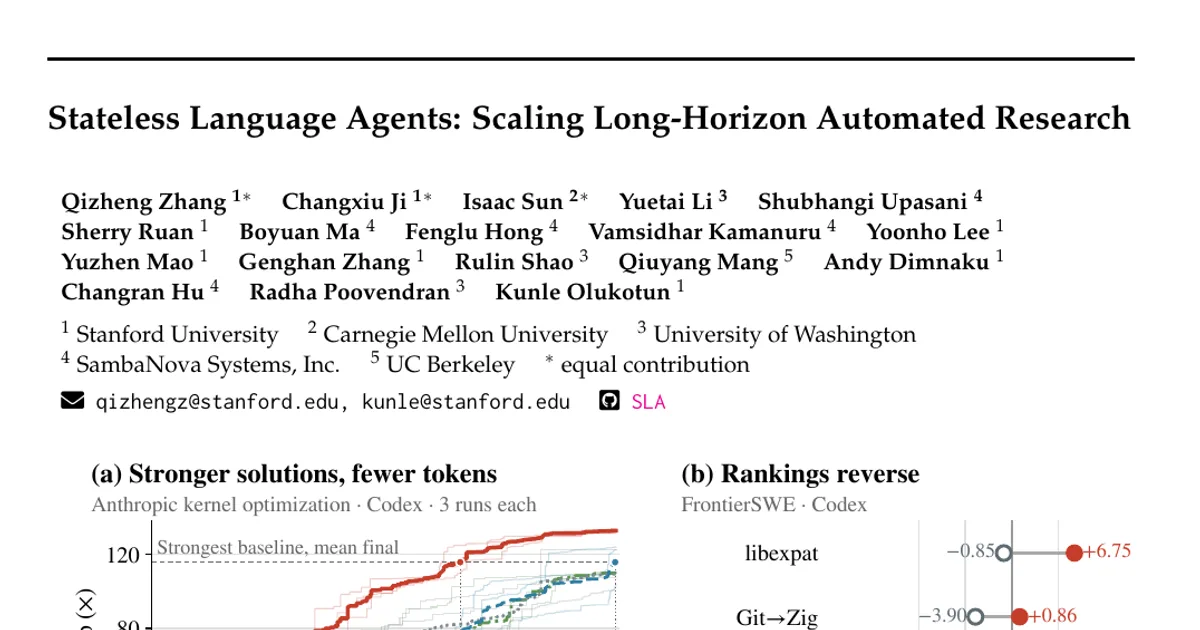
I sistemi di ricerca automatizzata impiegano sempre più spesso agenti basati su LLM per periodi prolungati, ma aumentare il calcolo in fase di inferenza non produce di per sé maggiori progressi: gli agenti ripercorrono cronologie sempre più lunghe, duplicano il lavoro gli uni degli altri oppure smettono di sperimentare mentre il consumo di token continua. Eppure, la maggior parte delle valutazioni usa budget ridotti o benchmark che raggiungono presto la saturazione, lasciando questi problemi senza verifica. Riconduciamo tali problemi a due scelte: dove risiede lo stato della ricerca e chi decide cosa provare in seguito. Presentiamo Stateless Language Agents (SLAs), basato sul principio di una ricerca con stato condotta da agenti senza stato: nessun agente conserva la propria conversazione da un’invocazione all’altra; è invece l’harness a gestire lo stato della ricerca (soluzioni candidate e risultati misurati) e a ricostruire per ogni invocazione un contesto nuovo e specifico per il ruolo dell’agente. Ciò che ciascun agente vede diventa una scelta progettuale esplicita, anziché una cronologia che si allunga con il procedere della ricerca. Applichiamo questo principio nel framework SLA, in cui un Advisor senza stato esamina le evidenze sintetizzate dall’harness relative a diverse direzioni di ricerca e assegna esperimenti concreti a Workers che operano in parallelo. Valutiamo SLA rispetto a tre framework recenti su compiti di ingegneria del software, ottimizzazione dei kernel e progettazione di algoritmi, con budget fino a un miliardo di token. SLA ottiene il miglior risultato finale in ogni compito e raggiunge le prestazioni finali della baseline più forte per l’ottimizzazione dei kernel usando oltre l’84% di token in meno. Gli studi di ablazione condotti a partire da checkpoint condivisi mostrano che i contesti mirati e le assegnazioni esplicite contribuiscono ciascuno ai progressi di SLA, con effetti che possono sommarsi nel corso di esecuzioni complete, mentre l’Advisor consuma meno dello 0,6% dei token. Questi risultati depongono a favore degli SLA, che mantengono lo stato persistente della ricerca fuori dalle conversazioni degli agenti, e mostrano che valutazioni su orizzonti brevi possono portare a giudicare erroneamente i sistemi di ricerca e i loro componenti.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv