Ricerca
Speculative Forcing per una generazione efficiente di video autoregressivi
I generatori autoregressivi di video a pochi passaggi consentono la generazione in streaming, ma sottopongono ogni token al passaggio finale di denoising, indipendentemente da quanto perfezionamento g
- arXiv
- 2610.22347
- Pubblicato
- 2026-10-15
- Autori
- Hyunwook Choi, Seungryong Kim, Dongyoon Han, Sangdoo Yun
Abstract degli autori
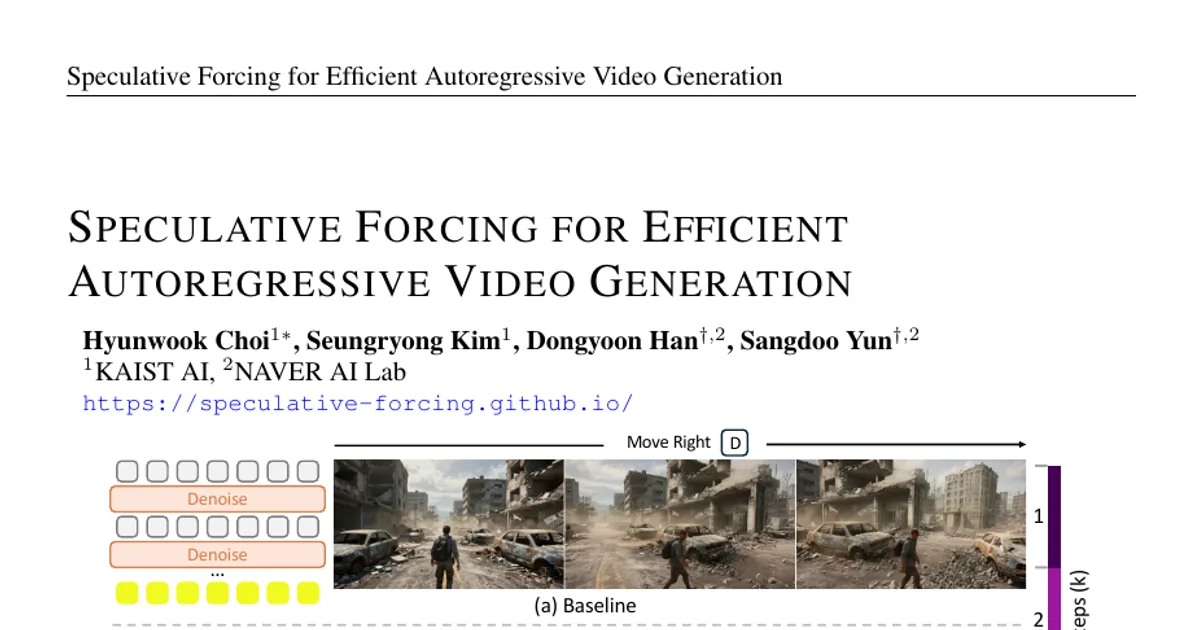
I generatori autoregressivi di video a pochi passaggi consentono la generazione in streaming, ma sottopongono ogni token al passaggio finale di denoising, indipendentemente da quanto perfezionamento gli serva. Abbiamo osservato che questo calcolo uniforme è spesso superfluo: già nei primi passaggi, molti token sono molto simili agli output che produrrebbero dopo tutti i passaggi, mentre altri richiedono perfezionamenti fino alla fine. Presentiamo Speculative Forcing, un framework che tratta le stime intermedie del contenuto pulito come bozze e prevede quando i singoli token possono essere accettati in anticipo senza rischi. Una volta accettato, un token viene congelato come output definitivo e non subisce ulteriori passaggi di denoising, mentre le sue chiavi e i suoi valori memorizzati nella cache restano disponibili come contesto per i token rimanenti. Esploriamo due approcci alternativi alla verifica: uno che non richiede addestramento, basato sulla somiglianza con il contenuto pulito e sulla stabilità tra i passaggi, e uno appreso, che usa le rappresentazioni intermedie del generatore congelato per stimare, per ciascun token, quanto sia ancora distante dall’output ottenuto dopo tutti i passaggi. Nella generazione di video brevi, video lunghi e mondi, Speculative Forcing preserva la qualità del campionamento con tutti i passaggi, riducendo sostanzialmente il calcolo. Su LongLive eguaglia il generatore a quattro passaggi con ~1,7 passaggi di denoising per token, funzionando a 41,7 e 37,8 fps con una velocità superiore di oltre 1,5 volte. Su Lingbot-World 2.0, dove il movimento della telecamera cambia continuamente il contenuto visibile, mantiene la qualità con ~2,5 passaggi di denoising per token e funziona a 24,5 fps con una velocità superiore di 1,35 volte.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv