Ricerca
SciFigBench: un benchmark per la comprensione delle figure che illustrano i metodi scientifici
Le figure che illustrano i metodi scientifici offrono spesso ai ricercatori un chiaro punto d’accesso visivo alla metodologia e ai contributi principali di un articolo, ma la densità della loro strutt
- arXiv
- 2610.27087
- Pubblicato
- 2026-10-19
- Autori
- Lijia Wu, Zheng Li, Yuxuan Liu, Jingwen Zhang, Penghai Zhao, Xiang Li
Abstract degli autori
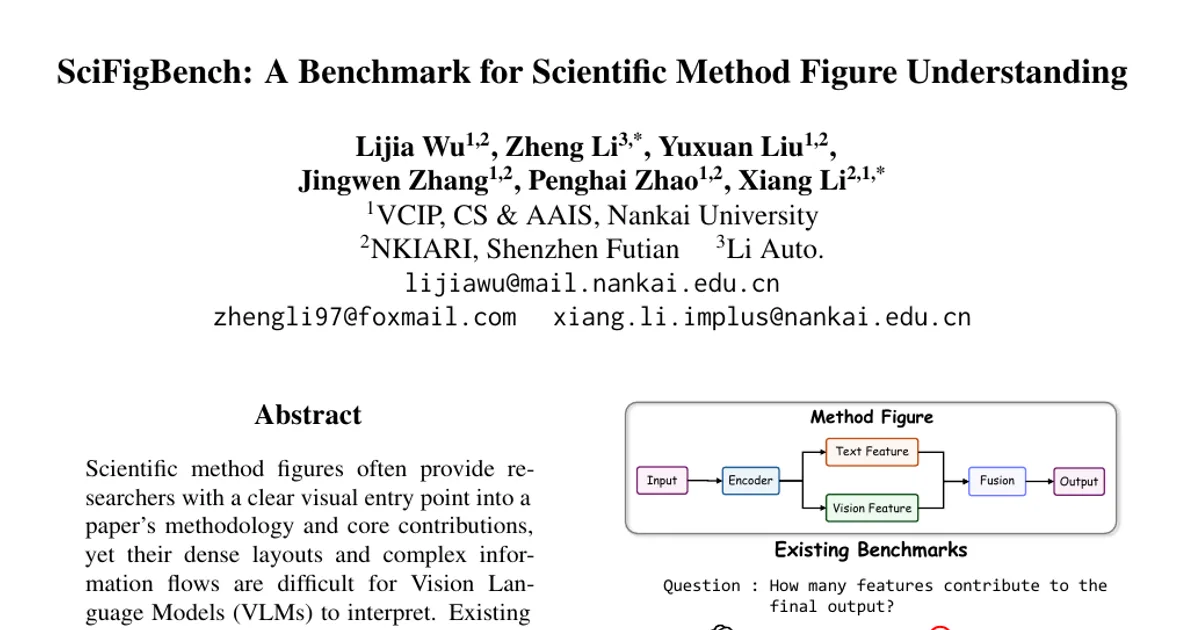
Le figure che illustrano i metodi scientifici offrono spesso ai ricercatori un chiaro punto d’accesso visivo alla metodologia e ai contributi principali di un articolo, ma la densità della loro struttura e la complessità dei flussi di informazioni le rendono difficili da interpretare per i modelli visivo-linguistici (VLM). I benchmark esistenti si concentrano prevalentemente su compiti a grana grossa, come il recupero basato sul contesto o la comprensione d’insieme, trascurando i contenuti di dettaglio e le relazioni tra moduli nei diagrammi metodologici complessi. Per affrontare questi aspetti trascurati, presentiamo Scientific Figure Benchmark (SciFigBench), un benchmark per valutare le capacità fondamentali necessarie a comprendere le figure che illustrano i metodi scientifici. In particolare, si concentra su tre capacità: percezione dei contenuti ad alta densità informativa, comprensione delle relazioni visive e tracciamento del flusso di informazioni. A questo scopo, raccogliamo 4.352 figure metodologiche tratte da articoli di ricerca reali e creiamo 40.670 coppie domanda-risposta per tradurre queste capacità in compiti misurabili. Tutte le annotazioni sono generate mediante pipeline dedicate e poi verificate manualmente. Proponiamo inoltre SciFigCue, un modulo di prompting visivo che non richiede addestramento e rende esplicite le dipendenze indicate dalle frecce come evidenze visive delle relazioni, utili per ragionare sulle figure metodologiche. Esperimenti condotti su VLM open source e proprietari mostrano che anche i modelli più avanzati presentano ancora limiti sostanziali nella comprensione delle relazioni visive, mentre SciFigCue migliora le prestazioni in diversi compiti senza aggiornare i parametri. Il codice e le risorse correlate sono disponibili all’indirizzo https://github.com/LeNcyer/SciFigBench.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv