Ricerca
RuleTrek: un benchmark per il ragionamento agentico sulle regole in scenari complessi
I modelli linguistici di grandi dimensioni (LLM) affrontano sempre più spesso compiti complessi del mondo reale in ambiti specialistici. Tuttavia, individuare e applicare correttamente le regole speci
- arXiv
- 2610.19698
- Pubblicato
- 2026-10-14
- Autori
- Chenhao Yuan, Bohan Yu, Yinhao Xu, Chao Yin, Chenxi Zhou, Zhaoxuan Wang, Shuwen Xu, Shaoping Huang, Haolin Ren, Jiaxiang Liu, Yao Xu, Jun Zhao, Kang Liu
Abstract degli autori
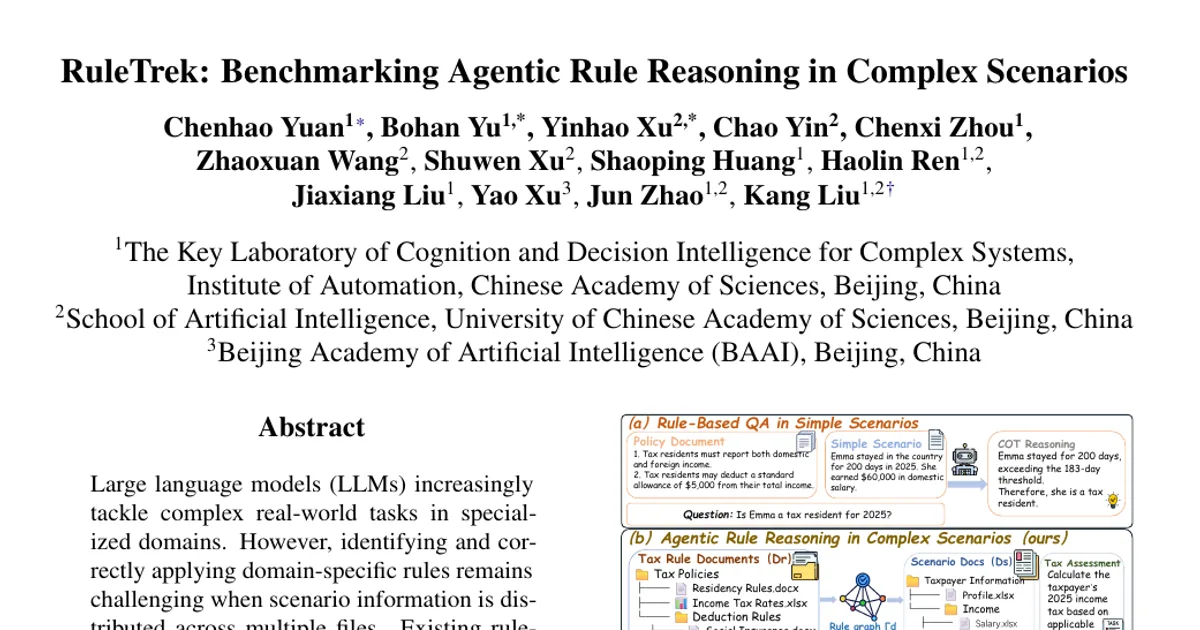
I modelli linguistici di grandi dimensioni (LLM) affrontano sempre più spesso compiti complessi del mondo reale in ambiti specialistici. Tuttavia, individuare e applicare correttamente le regole specifiche di un ambito resta difficile quando le informazioni sullo scenario sono distribuite tra più file. I benchmark esistenti per il ragionamento sulle regole rappresentano in genere gli scenari attraverso poche affermazioni fattuali, semplificando l’individuazione e l’applicazione delle regole pertinenti. Per colmare questa lacuna, questo articolo presenta \textbf{RuleTrek}, un benchmark multidominio per il ragionamento agentico sulle regole in scenari complessi. La procedura di costruzione basata sulle regole estrae grafi strutturati delle regole, genera sottoscenari specifici per ciascuna regola e li combina progressivamente, garantendo coerenza e risolvibilità. Per valutare sistematicamente il ragionamento agentico sulle regole in scenari complessi, RuleTrek esamina tre capacità in ambienti di lavoro interattivi: identificazione delle regole (RI), deduzione delle regole (RD) e ragionamento sulle regole end-to-end (E2E). Gli esperimenti su 11 LLM di frontiera mostrano che i punteggi più alti per RI e RD sono rispettivamente soltanto del 62,47\% e del 60,43\%, mentre quelli per E2E vanno dal 26,97\% al 55,29\%. Questi risultati dimostrano che gli attuali agenti basati su LLM incontrano notevoli difficoltà nel ragionare sulle regole in scenari complessi. Rendiamo pubblicamente disponibili il nostro codice e il nostro dataset su \href{https://github.com/yuan247/RuleTrek}{RuleTrek}.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv