Ricerca
PonderPounce: un MLLM preaddestrato come motore del contesto dell’episodio per il controllo robotico
I modelli linguistici multimodali di grandi dimensioni (MLLM) possono integrare lunghe sequenze di osservazioni visive, ragionare in condizioni di osservabilità parziale e inferire comportamenti da po
- arXiv
- 2608.24115
- Pubblicato
- 2026-08-25
- Autori
- Suhwan Choi, Jaeyoon Jung, Sungkyung Kim, Yunsung Lee, Youngjae Yu
Abstract degli autori
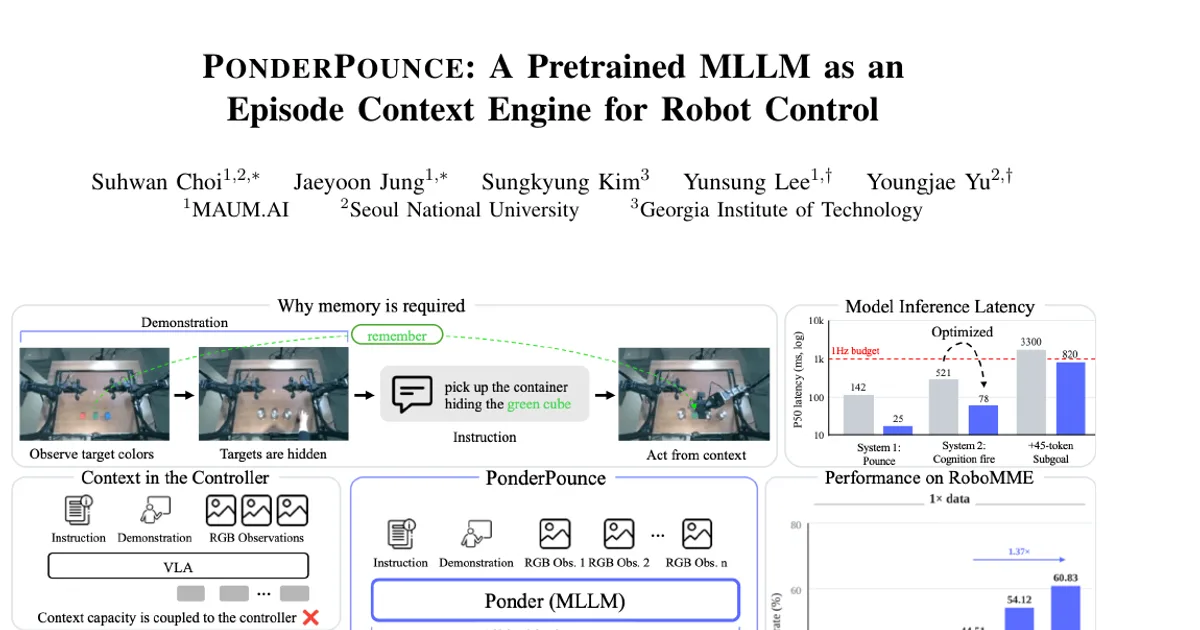
I modelli linguistici multimodali di grandi dimensioni (MLLM) possono integrare lunghe sequenze di osservazioni visive, ragionare in condizioni di osservabilità parziale e inferire comportamenti da pochi esempi. Eppure i modelli visione-linguaggio-azione (VLA) in genere ereditano rappresentazioni preaddestrate senza sfruttare questa capacità contestuale come memoria dell’episodio. Le politiche che dipendono dalla memoria colmano questa lacuna con meccanismi appositamente progettati per gestire la cronologia. PonderPounce, invece, riutilizza il contesto causale nativo di un MLLM come memoria del robot. Ponder, un MLLM System2, accumula osservazioni dell’episodio, dimostrazioni ed elaborazioni cognitive precedenti nel proprio contesto causale nativo e può generare testi sui sotto-obiettivi e ragionamenti sulle dimostrazioni per uso interno. Pounce, un VLA System1, riceve direttamente l’osservazione corrente, l’istruzione e le informazioni propriocettive; tramite l’interfaccia Ponder--Pounce, riceve in modo asincrono soltanto il token continuo di elaborazione cognitiva più recente e la sua età. Entrambi sono addestrati congiuntamente end-to-end, senza un modulo di memoria appositamente progettato né un preaddestramento separato del modulo di raccordo. Un sistema di esecuzione ottimizzato ottiene latenze p50 di 78 ms per l’aggiornamento dell’elaborazione cognitiva e di 25 ms per l’invocazione del modello di azione, consentendo l’esecuzione delle azioni a 20 Hz. Su RoboMME, con dati di addestramento su scala base, PonderPounce raggiunge il 60,83% con 9B e il 50,04% con 0.8B, usando la stessa architettura Pounce e la stessa interfaccia, contro il 44,51% di FrameSamp+Modul e il 17,93% di π_{0.5} basato sull’osservazione corrente. Con una quantità di dati 9 volte superiore, raggiunge il 75,54%, contro il 57,88% di FrameSamp+Modul. Su RoboCasa-DC, la stessa interfaccia apprende dalla sola supervisione delle azioni e raggiunge il 12,5%, contro l’11,6% della più efficace baseline pubblicata condizionata dalle dimostrazioni; il risultato scende all’8,6% quando l’elaborazione cognitiva viene sostituita da uno stato nullo appreso.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv