Ricerca
OmniCam: generazione di traiettorie per telecamere omnidirezionali tramite l’apprendimento di token di posa ancorati alla geometria
Le traiettorie della telecamera controllano i cambiamenti di punto di vista nella generazione di video, nella ricostruzione di scene e nella percezione robotica. Generarle a partire dal linguaggio ric
- arXiv
- 2610.09513
- Pubblicato
- 2026-10-07
- Autori
- Zhenyang Liu, Chenjie Cao, Yisu Zhang, Xuhui Zuo, Xiangyang Xue, Yanwei Fu, Tengfei Wang, Chunchao Guo
Abstract degli autori
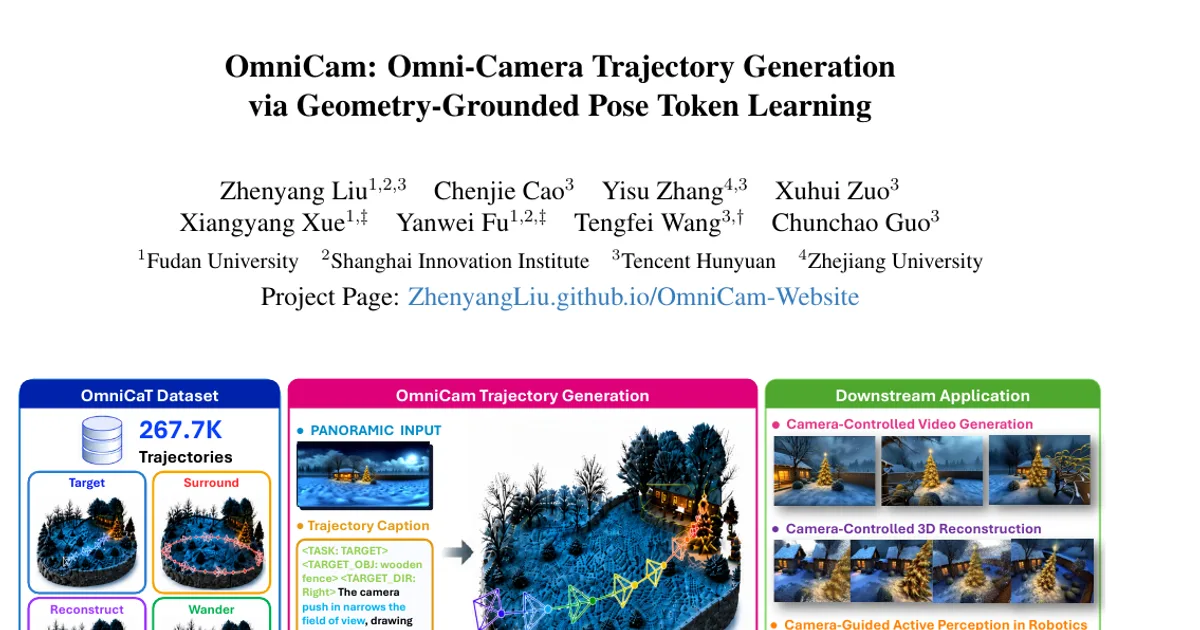
Le traiettorie della telecamera controllano i cambiamenti di punto di vista nella generazione di video, nella ricostruzione di scene e nella percezione robotica. Generarle a partire dal linguaggio richiede sia la geometria della scena sia un’inquadratura che tenga conto del bersaglio. Presentiamo OmniCam, un modello autoregressivo che genera sequenze di pose della telecamera a partire da un solo panorama e da descrizioni testuali delle traiettorie. Il suo apprendimento di token di posa ancorati alla geometria combina tre componenti: un codificatore di nuvole di punti panoramiche per il contesto geometrico omnidirezionale; una tokenizzazione ibrida della rotazione assoluta e della traslazione relativa, con segni dei quaternioni coerenti nel tempo; e flussi separati di condizionamento geometrico e semantico, con un ancoraggio esplicito al bersaglio in 3D. Abbiamo inoltre costruito OmniCaT, che contiene 267.700 traiettorie relative a quattro comportamenti della telecamera. Nella valutazione riportata su OmniCaT, OmniCam riduce gli errori delle traiettorie del 28–47% e il tasso di collisione del 65,8% rispetto a GenDoP riaddestrato su OmniCaT. Rispetto alla migliore baseline per ciascuna metrica, le riduzioni dell’ATE e delle collisioni sono rispettivamente del 43,0% e del 62,3%. Gli studi di ablazione delle componenti sostengono l’utilità del condizionamento geometrico e di quello che tiene conto del bersaglio, mentre gli esperimenti a valle esaminano la generazione di video controllata dalla telecamera e la percezione attiva robotica.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv