Ricerca
MotorMind: una struttura di supporto per modelli visivo-linguistici generalisti nella manipolazione robotica zero-shot
I modelli visione-linguaggio-azione (VLA) hanno fatto progredire la manipolazione robotica, ma la loro capacità di generalizzare in modalità zero-shot a nuovi compiti e ambienti resta limitata. Inoltr
- arXiv
- 2609.38078
- Pubblicato
- 2026-09-29
- Autori
- Bingxuan Li, Siqi Song, Yizhuo Wu, Jiarui Yao, Tong Zhang, Huan Zhang
Abstract degli autori
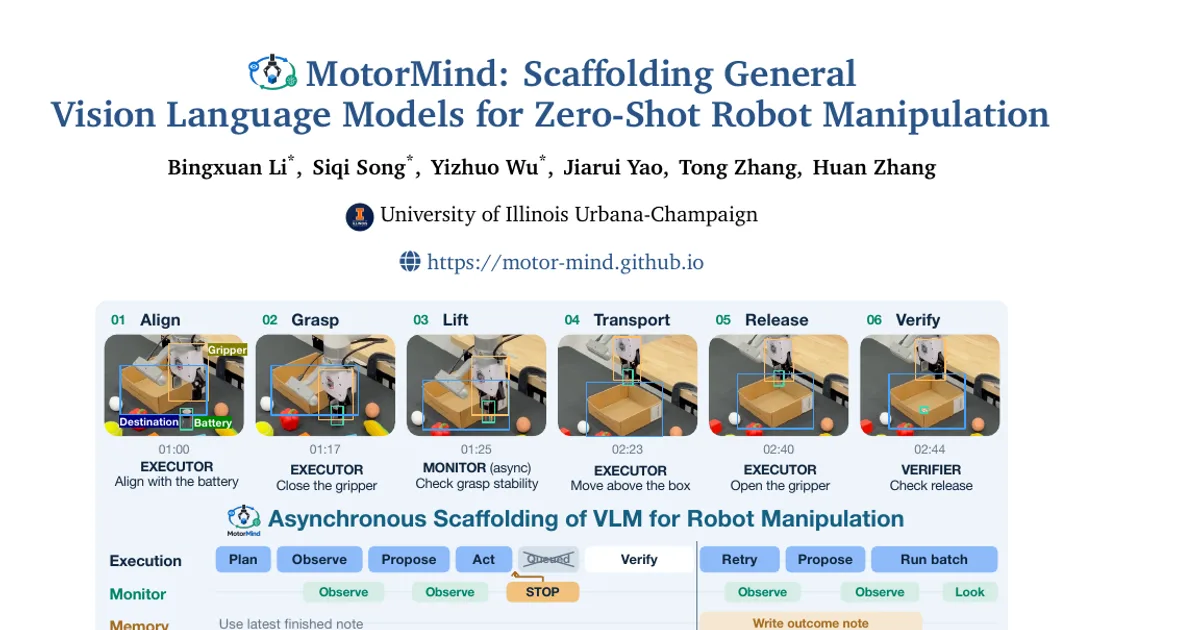
I modelli visione-linguaggio-azione (VLA) hanno fatto progredire la manipolazione robotica, ma la loro capacità di generalizzare in modalità zero-shot a nuovi compiti e ambienti resta limitata. Inoltre, la dipendenza da un addestramento specializzato impedisce loro di beneficiare direttamente dei rapidi progressi dei modelli visivo-linguistici (VLM) generalisti. Parallelamente, i recenti sistemi robotici basati su agenti impiegano VLM per il ragionamento ad alto livello o agenti di programmazione per il controllo dei robot, ma spesso dipendono da numerosi modelli e strumenti esterni, introducendo ulteriore complessità e costi. Ci chiediamo quindi: un VLM generalista può controllare un robot in modo più simile a un teleoperatore umano, ragionando direttamente a partire dalle osservazioni, impartendo azioni e adattandosi continuamente al feedback dell’esecuzione, senza ricorrere a modelli esterni come esperti delle azioni appresi, agenti di programmazione o strumenti di grounding come SAM3? In questo lavoro presentiamo MotorMind, una struttura di supporto per la manipolazione robotica che collega le azioni di livello intermedio proposte dal VLM al controllo deterministico del robot e al feedback, con monitoraggio asincrono e aggiornamenti della memoria in background. Senza addestramento di policy specifiche per i compiti, agenti di programmazione o ulteriori strumenti di grounding come SAM3, MotorMind raggiunge un tasso di successo del 66,7% nelle suite di base LIBERO-PRO e del 53,8% in presenza di perturbazioni, rispetto a un massimo, rispettivamente, del 13,3% e del 19,2% per i precedenti metodi zero-shot che valutiamo. La stessa interfaccia raggiunge un tasso medio di successo del 95% su un robot xArm6 reale, sia nella manipolazione diretta sia in presenza di perturbazioni introdotte da esseri umani. Sostituire il modello di base con un VLM più potente migliora ulteriormente le prestazioni, mentre gli insuccessi residui, dovuti principalmente al grounding visivo, al ragionamento legato all’interazione fisica con l’ambiente e alla conoscenza delle azioni, diminuiscono con il migliorare delle capacità del VLM. Questi risultati mostrano che un VLM generalista, dotato di un’adeguata rappresentazione delle azioni di livello intermedio e di una struttura di supporto per l’esecuzione asincrona, può svolgere efficacemente compiti di manipolazione robotica zero-shot.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv