Ricerca
Più opzioni, meno decisioni: distorsione legata alla scala ordinale nei modelli a decisione diretta simili a JEV
I modelli a decisione diretta trasformano il testo in etichette e punteggi strutturati con bassa latenza, risultando interessanti per la classificazione e la valutazione automatica. Ma l’affidabilità
- arXiv
- 2609.38827
- Pubblicato
- 2026-09-30
- Autori
- Tianxiang Gao, Jinzhe Li, Zhiyuan Li, Yi Chang, Yuan Wu
Abstract degli autori
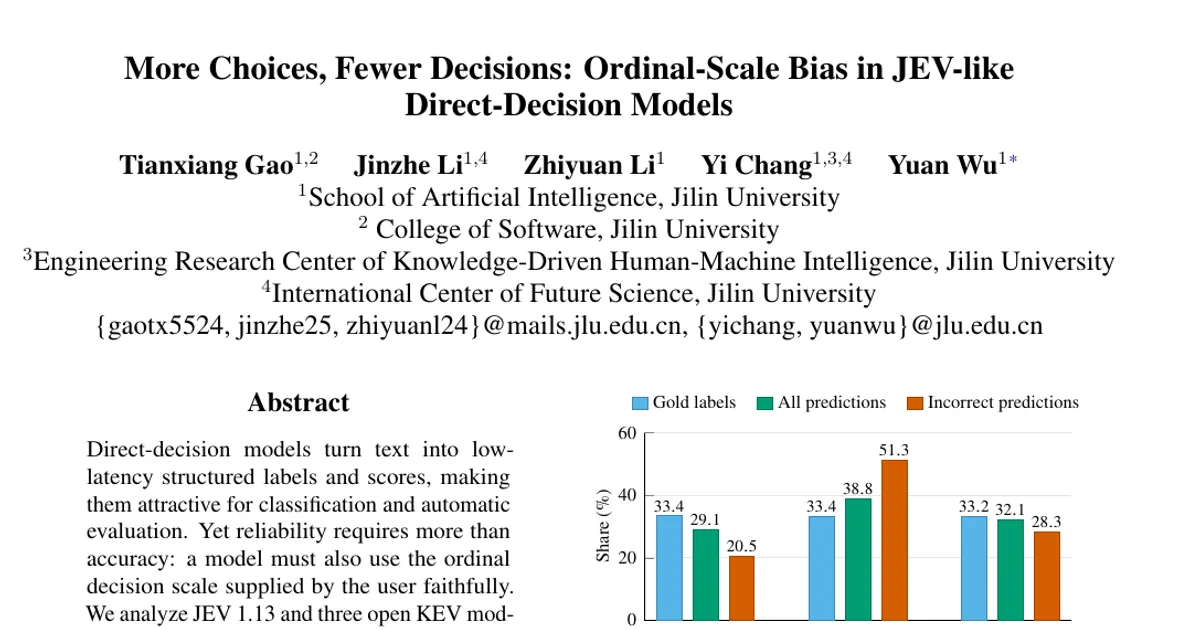
I modelli a decisione diretta trasformano il testo in etichette e punteggi strutturati con bassa latenza, risultando interessanti per la classificazione e la valutazione automatica. Ma l’affidabilità richiede più della semplice accuratezza: un modello deve anche usare fedelmente la scala ordinale fornita dall’utente per prendere le decisioni. Analizziamo JEV~1.13 e tre modelli KEV aperti. La nostra indagine parte da ANLI, dove JEV assegna alla categoria Neutral il 38,8\% di tutte le predizioni e il 51,3\% degli errori, nonostante un’accuratezza del 74,95\%, etichette di riferimento quasi bilanciate e posizioni delle opzioni bilanciate. Su 36 dataset ordinali, le decisioni finali utilizzano solo il 67--76\% del supporto effettivo delle etichette di riferimento, contro l’87--102\% in quattro compiti nominali. La randomizzazione dell’ordine delle opzioni attenua questa compressione, ma non la elimina. Mantenendo invariati gli elementi e i punteggi di partenza, e bilanciando il supporto delle etichette di riferimento e le posizioni, aumentiamo la granularità delle scale da $K=2$ a $14$: l’utilizzo diminuisce per ogni modello e arriva al 26--75\% per $K=14$, sebbene per la maggior parte dei modelli le probabilità assegnate alle opzioni restino distribuite su un ampio intervallo. Un post-training mirato con BA-LoRA porta l’utilizzo rispetto al supporto delle etichette di riferimento da circa il 47\% all’86\% su otto scale usate nell’addestramento supervisionato, per entrambe le dimensioni di KEV. Questo mostra che la compressione è appresa e modificabile, anziché un limite architetturale immutabile. Chiamiamo questo fenomeno distorsione nell’utilizzo della scala ordinale: una compressione dello spazio delle opzioni nella fase decisionale, distinta dall’accuratezza, dallo sbilanciamento delle etichette di riferimento, dalla posizione fissa e dal solo numero di opzioni. Il codice e i dati sono disponibili all’indirizzo https://github.com/Glax147/jev_ordinal_scale_bia
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv