Ricerca
Modelli mondo-azione autoregressivi per modalità
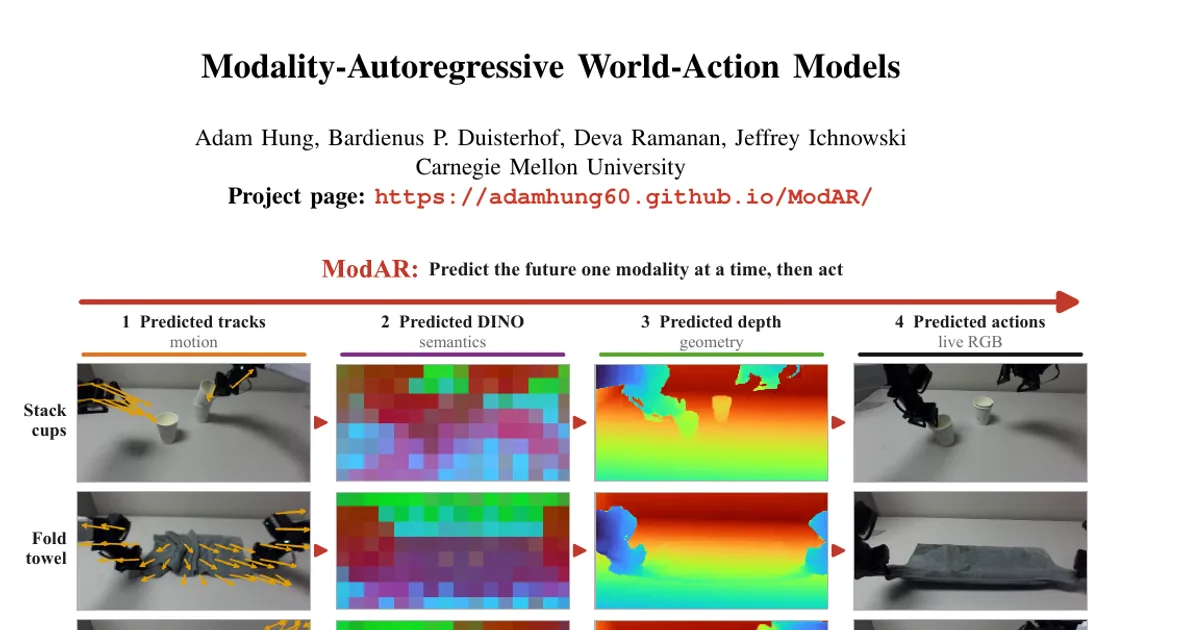
I modelli mondo-azione (WAM) modellano congiuntamente le osservazioni e le azioni future, di norma prevedendo il futuro sotto forma di immagini RGB. Altre modalità visive, come la profondità, le carat
- arXiv
- 2609.17524
- Pubblicato
- 2026-09-15
- Autori
- Adam Hung, Bardienus P. Duisterhof, Deva Ramanan, Jeffrey Ichnowski
Abstract degli autori
I modelli mondo-azione (WAM) modellano congiuntamente le osservazioni e le azioni future, di norma prevedendo il futuro sotto forma di immagini RGB. Altre modalità visive, come la profondità, le caratteristiche visive preaddestrate e le traiettorie di punti, possono rappresentare con maggiore efficienza le caratteristiche geometriche, semantiche e del movimento. Resta però aperta la questione di come combinarle al meglio nei WAM. Presentiamo ModAR, il primo WAM che rimuove autoregressivamente il rumore da più modalità future prima di prevedere le azioni. In questo modo, ogni previsione può basarsi sulle modalità generate in precedenza. Addestriamo il modello da zero per studiare sistematicamente come le combinazioni dei dati di addestramento, le modalità previste e le formulazioni dei WAM influenzino le prestazioni. Nelle nostre valutazioni, i WAM traggono beneficio dalla previsione delle traiettorie di punti, delle caratteristiche DINO e delle mappe di profondità, mentre prevedere anche le immagini RGB future non offre un vantaggio costante. Riscontriamo inoltre che la generazione sequenziale di ModAR supera le formulazioni esistenti dei WAM, ottenendo il più alto tasso medio di successo a tutte le dimensioni dei dati valutate. Eseguiamo anche il fine-tuning di Flex-$π$, un WAM inizializzato a partire da un modello video, sugli stessi dati: ModAR ottiene un tasso medio di successo osservato leggermente più alto (75% contro 72%), pur impiegando un numero di FLOP per l’addestramento inferiore di circa $20\times$ e senza preaddestramento. In tre attività bimanuali nel mondo reale, ModAR supera i modelli di riferimento e migliora con i video di persone.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv