Ricerca
Misurare la diversità dei dati con gli embedding: una tassonomia e un benchmark per le misure di diversità
La diversità è una proprietà fondamentale dei corpora testuali, con implicazioni dirette per la cura dei dati di addestramento, la progettazione dei set di test e la capacità di generalizzazione dei m
- arXiv
- 2610.24888
- Pubblicato
- 2026-10-17
- Autori
- Cantao Su, Anna Wegmann, Esther Ploeger, Dong Nguyen
Abstract degli autori
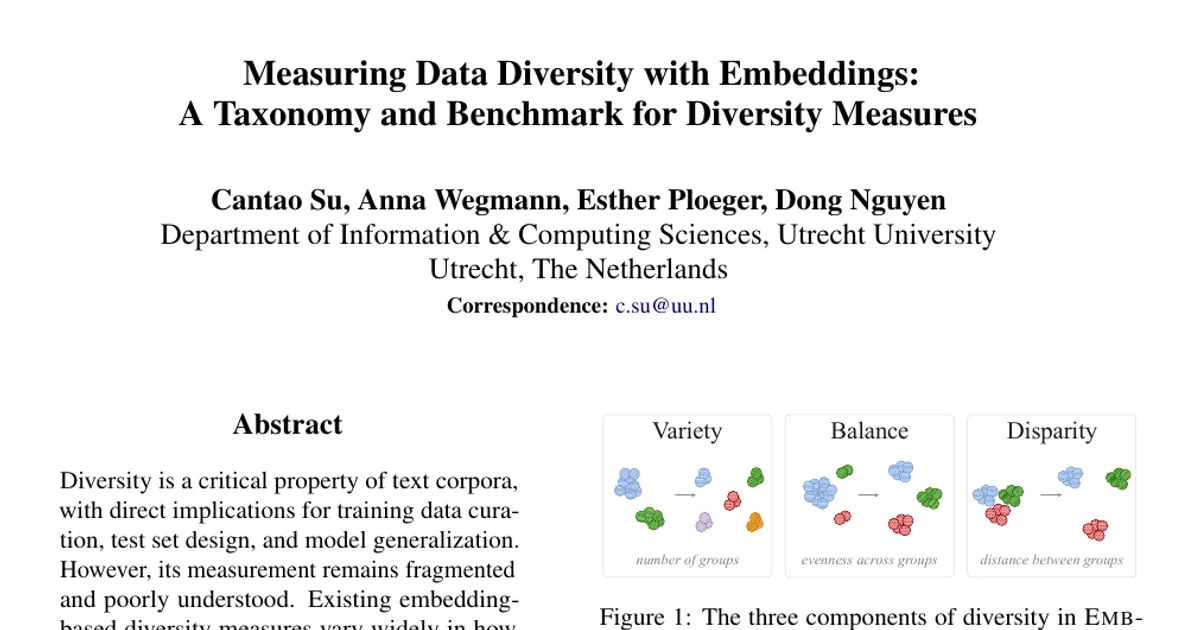
La diversità è una proprietà fondamentale dei corpora testuali, con implicazioni dirette per la cura dei dati di addestramento, la progettazione dei set di test e la capacità di generalizzazione dei modelli. La sua misurazione, tuttavia, resta frammentata e poco compresa. Le misure di diversità basate sugli embedding differiscono notevolmente per il modo in cui vengono calcolate e possono attribuire punteggi di diversità molto diversi agli stessi dati, ma manca un confronto sistematico del loro comportamento empirico. Per contribuire a colmare questa lacuna, presentiamo due risultati. Il primo è una tassonomia di 21 misure di diversità basate sugli embedding, suddivise in quattro famiglie secondo i calcoli su cui si fondano. Il secondo è EmbDivBench, un benchmark che valuta queste misure rispetto a tre componenti concettualmente distinte — varietà, equilibrio e disparità — su dati testuali sia simulati sia naturali. Sebbene Mean Pairwise Distance sia la misura più usata, i nostri esperimenti mostrano che diverse alternative ottengono risultati migliori nelle tre componenti della diversità e che Graph Entropy è la scelta migliore nel complesso. Infine, traduciamo questi risultati in raccomandazioni pratiche per la scelta di una misura di diversità.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv