Ricerca
LightNav-0: sfruttare l’intelligenza spaziale dei VLM per la navigazione incarnata generalista
La navigazione incarnata richiede ad agenti di tradurre obiettivi eterogenei e osservazioni visive in azioni, in compiti e ambienti diversi e con differenti configurazioni robotiche. I moderni modelli
- arXiv
- 2608.30935
- Pubblicato
- 2026-08-31
- Autori
- Shaoan Wang, Aocheng Luo, Fei Huang, Jingyi Xu, Xiaoyang Wang, Yueyu Wang, Qianli Ma, Fan Yang, Ran Mei, Jia Wei, Jiangpeng Hu, Xuhao Liu, Hongming Chen, Yuanbin Shao, Yiyang Lin, Ziliang Li, Liang Pan, Xinhang Liu, Yuntao Ma, Tingxiang Fan
Abstract degli autori
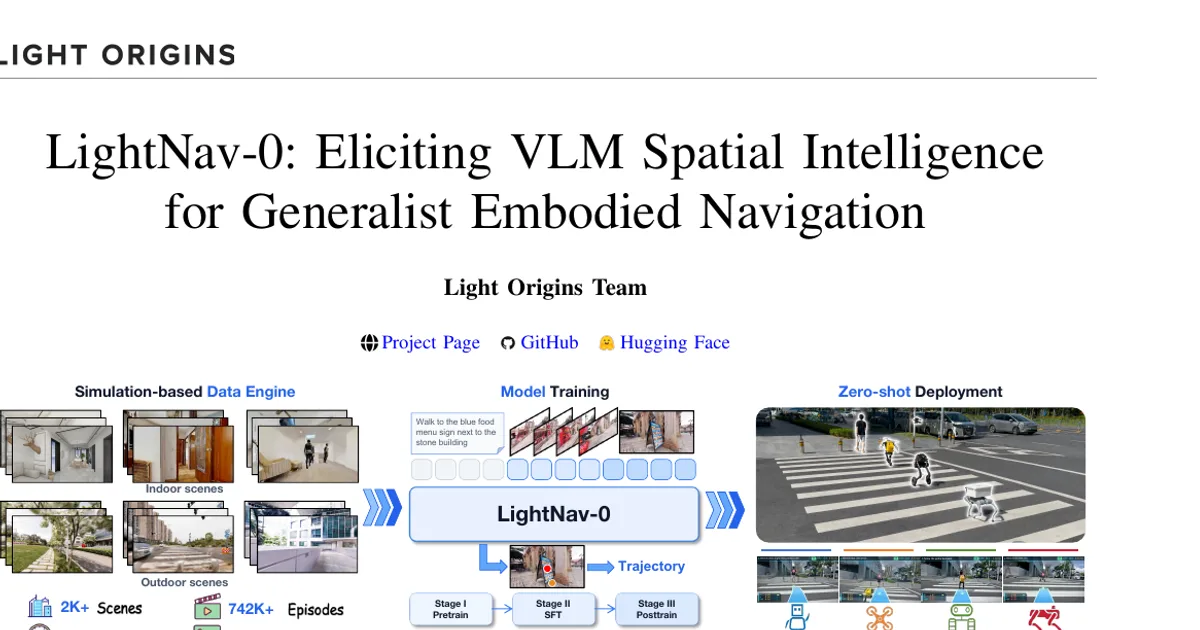
La navigazione incarnata richiede ad agenti di tradurre obiettivi eterogenei e osservazioni visive in azioni, in compiti e ambienti diversi e con differenti configurazioni robotiche. I moderni modelli visione-linguaggio (VLM) incorporano già conoscenze spaziali preliminari utili per l’ancoraggio visivo, il ragionamento spaziale e l’indicazione di punti, ma queste capacità vengono raramente sfruttate direttamente per il controllo dei robot. I sistemi di navigazione esistenti si affidano invece a componenti specifici per il compito o per la configurazione robotica, separando percezione, ragionamento e azione e offrendo una capacità di generalizzazione limitata. Presentiamo LightNav-0, un modello compatto di navigazione incarnata generalista che sfrutta l’intelligenza spaziale di un VLM preaddestrato e la adatta alla navigazione, senza componenti di predizione specifici per ciascun compito. LightNav-0 rappresenta diversi compiti di navigazione attraverso un’interfaccia unificata basata su token: l’indicazione a due canali esprime un intento spaziale indipendente dal compito, dalla scena e dalla configurazione robotica, mentre un tokenizer delle azioni con quantizzazione vettoriale residua traduce tale intento in traiettorie precise, specifiche per ciascuna configurazione robotica. Insieme alla compressione della cronologia visiva che tiene conto della dimensione temporale, al training intermedio ER, al fine-tuning supervisionato e all’apprendimento per rinforzo, questa formulazione consente a un unico modello di seguire istruzioni, navigare verso oggetti identificati con un vocabolario aperto ed effettuare il tracciamento visivo. Il corpus di addestramento per la navigazione comprende oltre 2K scene e oltre 4K ore di dati di navigazione incarnata. LightNav-ER, il checkpoint di ragionamento incarnato usato per inizializzare LightNav-0, ottiene la media più alta sull’insieme completo in 8 benchmark di ragionamento incarnato, mentre LightNav-0 raggiunge tassi di successo con visione monoculare all’avanguardia in tutti e 10 gli scenari pubblici di simulazione della navigazione. Le valutazioni nel mondo reale dimostrano inoltre una generalizzazione zero-shot a diverse configurazioni robotiche, scene eterogenee e bersagli statici e dinamici. Questi risultati mostrano che i VLM compatti possono costituire una base unificata e trasferibile per la navigazione incarnata generalista.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv