Ricerca
Meno da più: rafforzare il ragionamento su video con pochi fotogrammi grazie a riferimenti densi
I modelli video-linguistici presumono comunemente che un maggior numero di osservazioni temporali renda il ragionamento più affidabile. Mettiamo in discussione questa ipotesi e sosteniamo che la sfida
- arXiv
- 2610.10893
- Pubblicato
- 2026-10-07
- Autori
- Wenfang Sun, Yingjun Du, Cees G. M. Snoek
Abstract degli autori
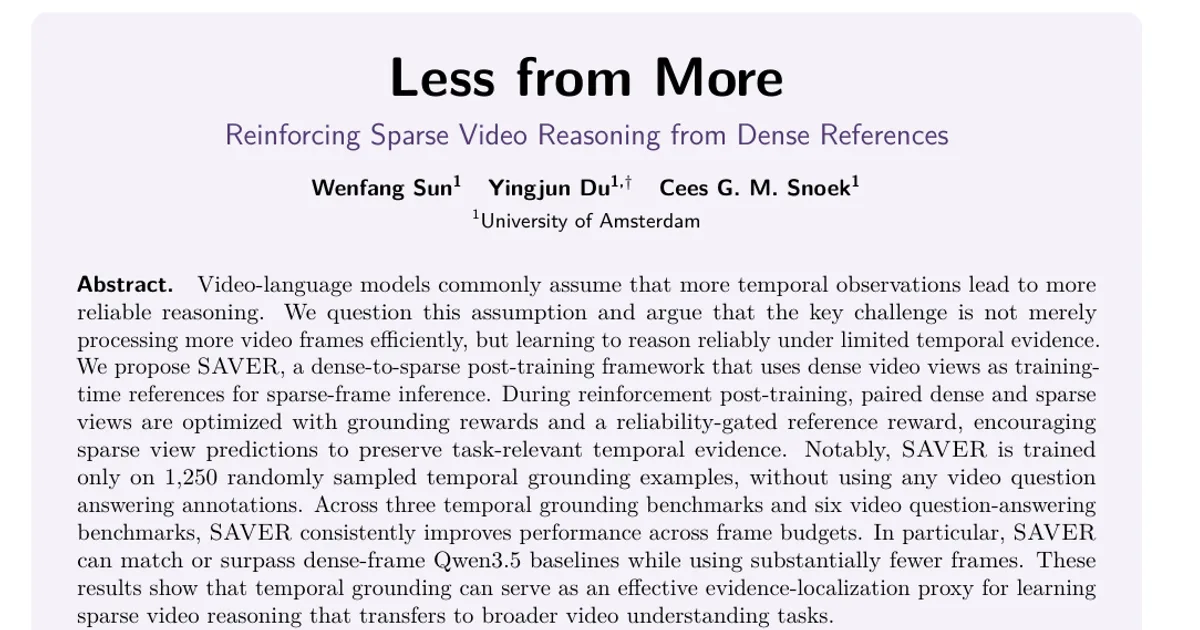
I modelli video-linguistici presumono comunemente che un maggior numero di osservazioni temporali renda il ragionamento più affidabile. Mettiamo in discussione questa ipotesi e sosteniamo che la sfida principale non sia soltanto elaborare in modo efficiente più fotogrammi, ma imparare a ragionare in modo affidabile quando le evidenze temporali sono limitate. Proponiamo SAVER, un framework di post-addestramento dal denso al rado che usa viste dense dei video come riferimenti durante l’addestramento per l’inferenza basata su pochi fotogrammi. Durante il post-addestramento per rinforzo, si ottimizzano coppie di viste dense e rade mediante ricompense per la localizzazione temporale e una ricompensa di riferimento subordinata all’affidabilità, incoraggiando le previsioni basate sulle viste rade a preservare le evidenze temporali rilevanti per il compito. SAVER, in particolare, viene addestrato soltanto su 1.250 esempi di localizzazione temporale campionati casualmente, senza usare annotazioni per la risposta a domande sui video. Su tre benchmark di localizzazione temporale e sei benchmark di risposta a domande sui video, SAVER migliora sistematicamente le prestazioni con diversi limiti al numero di fotogrammi. In particolare, SAVER può eguagliare o superare le baseline Qwen3.5 basate su molti fotogrammi, pur utilizzandone un numero sostanzialmente inferiore. Questi risultati mostrano che la localizzazione temporale può fungere da efficace proxy per la localizzazione delle evidenze nell’apprendimento del ragionamento su video con pochi fotogrammi, trasferibile a compiti più ampi di comprensione dei video.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv