Ricerca
LEGO: un approccio senza lifting per generare video egocentrici da video esocentrici
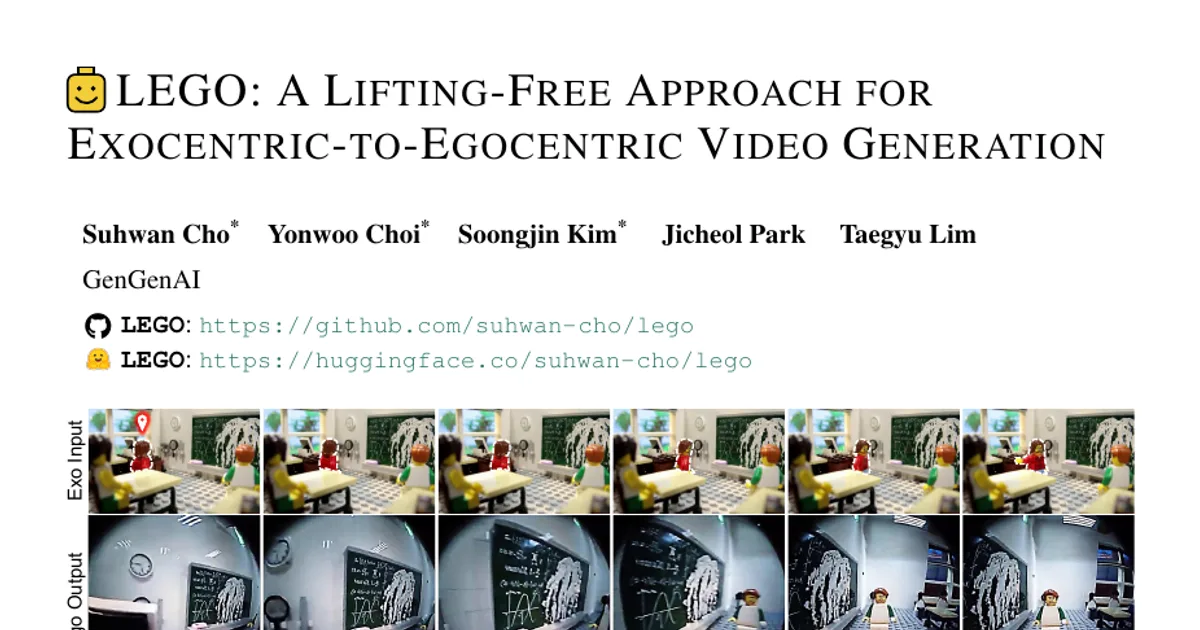
Generare un video egocentrico a partire da una sola registrazione esocentrica è un problema difficile di sintesi di nuove viste: le due telecamere hanno un campo visivo poco sovrapposto e gran parte d
- arXiv
- 2610.12442
- Pubblicato
- 2026-10-08
- Autori
- Suhwan Cho, Yonwoo Choi, Soongjin Kim, Jicheol Park, Taegyu Lim
Abstract degli autori
Generare un video egocentrico a partire da una sola registrazione esocentrica è un problema difficile di sintesi di nuove viste: le due telecamere hanno un campo visivo poco sovrapposto e gran parte della vista da generare non è osservabile. Gli attuali metodi più avanzati ricostruiscono esplicitamente la scena stimando la profondità, trasformando il video in una nuvola di punti e renderizzandolo di nuovo dalla prospettiva della telecamera egocentrica per condizionare un modello di diffusione video. Questa mappatura deterministica assegna ogni pixel a un’unica posizione riproiettata: preserva la texture, ma fa sì che gli errori di profondità collochino i contenuti nel posto sbagliato. Ci chiediamo quale input di condizionamento debba ricevere un modello di diffusione video e proponiamo una risposta che non richiede lifting: un sintetizzatore di viste appreso, un transformer in stile LVSM sottoposto a fine-tuning per renderizzare direttamente la vista egocentrica senza profondità, nuvole di punti o riproiezione, risolvendo internamente le corrispondenze tra le viste. La sua mappatura probabilistica, invece, calcola per ogni regione una media sulle posizioni sorgente candidate in base a una distribuzione appresa delle corrispondenze, preservando la struttura mentre le texture fini vengono attenuate dalla media. Sosteniamo che questo compromesso sia adatto a un generatore basato sulla diffusione, il cui addestramento al denoising è particolarmente efficace nel ripristinare i dettagli: un input di condizionamento efficace dovrebbe quindi dare priorità all’allineamento strutturale rispetto alla nitidezza. Il grado di concentrazione di questa distribuzione fornisce inoltre una misura di affidabilità per ciascuna regione, usata sia per mascherare quelle poco affidabili sia per guidare il generatore verso quelle più affidabili nelle prime fasi del denoising, quando si definisce la disposizione degli elementi. Il nostro approccio supera sistematicamente la pipeline esplicita più avanzata e si generalizza ad altri dataset senza riaddestramento. Il sintetizzatore fornisce quindi la struttura della vista e il modello di diffusione i dettagli.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv