Ricerca
Apprendere a prevedere senza traiettorie esplicite per le policy di diffusione 3D
Le policy di diffusione 3D sono efficaci nel generare azioni fondate sulla geometria a partire dalle osservazioni correnti, ma per manipolare con successo non basta sapere quali movimenti siano fattib
- arXiv
- 2609.20669
- Pubblicato
- 2026-09-17
- Autori
- Zhongbo Zhang, Zaibin Zhang, Yifan Wang, Changbo Yan, Lijun Wang, Huchuan Lu
Abstract degli autori
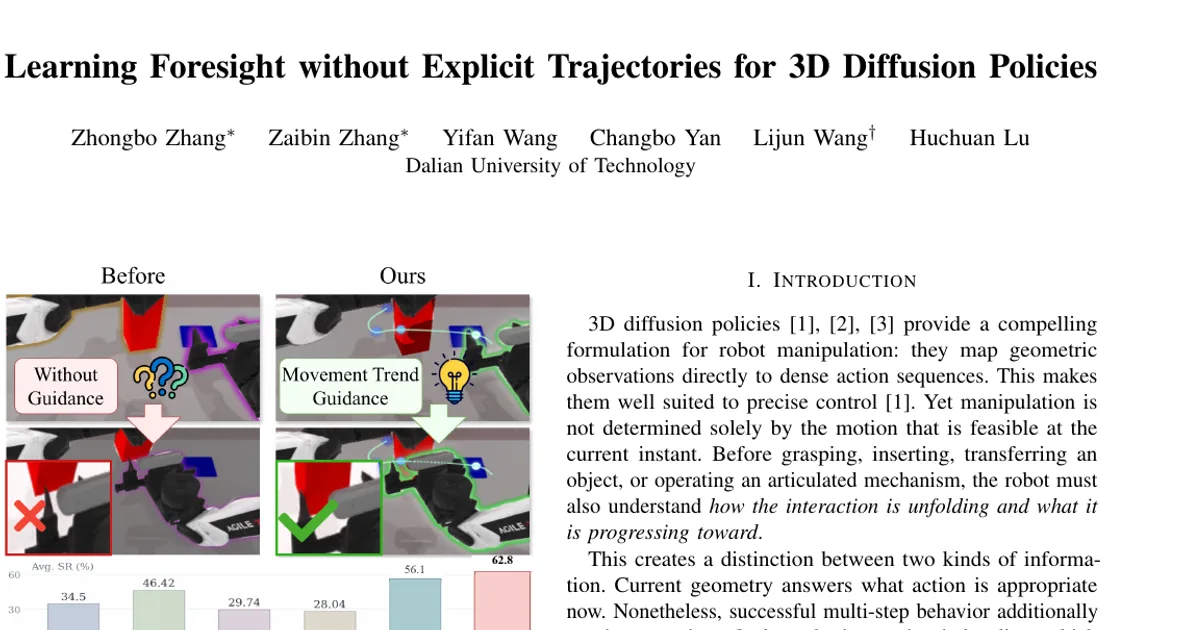
Le policy di diffusione 3D sono efficaci nel generare azioni fondate sulla geometria a partire dalle osservazioni correnti, ma per manipolare con successo non basta sapere quali movimenti siano fattibili nell’immediato: occorre anche anticipare la direzione verso cui si sta evolvendo l’interazione. Le policy esistenti affidano in gran parte questa capacità di anticipazione all’apprendimento implicito delle azioni. Introduciamo Movement Trend Guidance, un metodo semplice ma efficace per fornire questa capacità senza introdurre un piano esplicito. A partire da una breve cronologia di osservazioni, la policy apprende una rappresentazione latente compatta dell’evoluzione dell’interazione. Durante l’addestramento, stati futuri radi della pinza supervisionano questa rappresentazione; in fase di inferenza, si mantiene solo la variabile latente, come condizionamento orientato al futuro insieme all’osservazione corrente. La variabile latente fornisce un condizionamento globale per la generazione delle azioni, mentre un ramo FiLM aggiuntivo con gating viene usato solo nel collo di bottiglia dell’UNet. Pur aggiungendo soltanto il 3,52% di parametri in più a DP3, il nostro metodo conserva la formulazione originale ad azioni dense e a orizzonte mobile e migliora costantemente le prestazioni di DP3 su RoboTwin2.0, LIBERO-40 e DexArt. Raggiunge il 62,8% contro il 56,1% nell’addestramento misto sui 50 task di RoboTwin2.0, il 71,93% contro il 37,08% su LIBERO-40 e il 72,0% contro il 49,0% su cinque task con robot reali. Questi risultati mostrano che una policy di diffusione può trarre notevoli benefici dal sapere verso dove si sta dirigendo un’interazione, senza che le venga indicato esattamente dove muoversi.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv