Ricerca
Inversione degli indici multi-vettoriali di documenti visivi
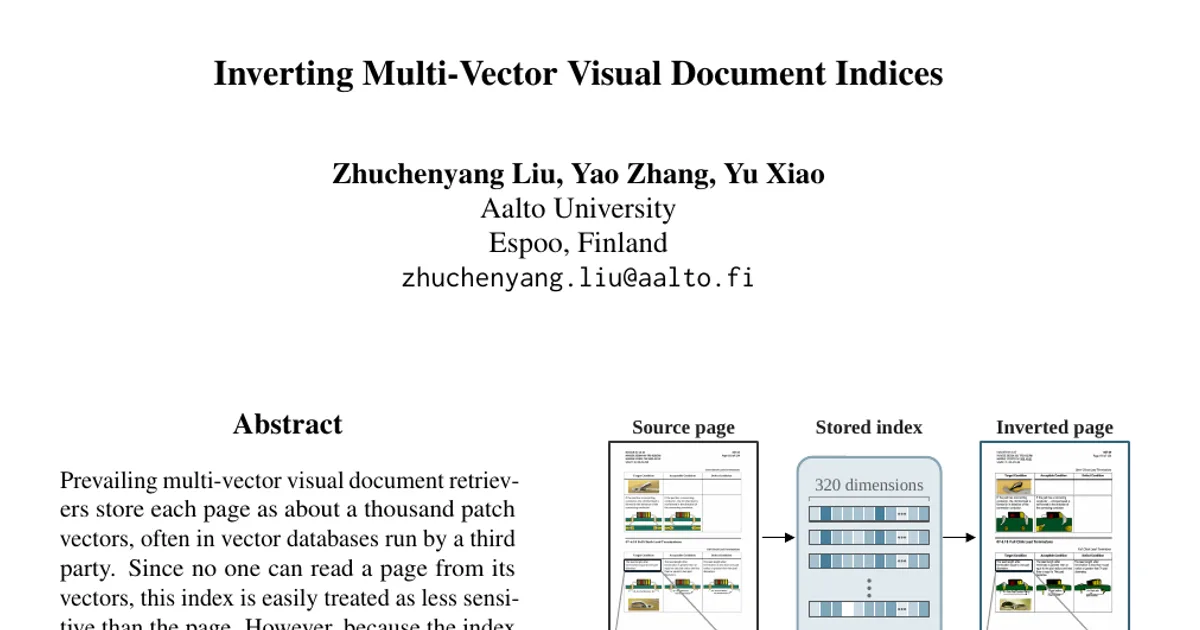
I sistemi di recupero multi-vettoriali di documenti visivi più diffusi memorizzano ogni pagina sotto forma di circa mille vettori di patch, spesso in database vettoriali gestiti da terzi. Poiché nessu
- arXiv
- 2610.09920
- Pubblicato
- 2026-10-07
- Autori
- Zhuchenyang Liu, Yao Zhang, Yu Xiao
Abstract degli autori
I sistemi di recupero multi-vettoriali di documenti visivi più diffusi memorizzano ogni pagina sotto forma di circa mille vettori di patch, spesso in database vettoriali gestiti da terzi. Poiché nessuno può leggere una pagina a partire dai suoi vettori, è facile considerare questo indice meno sensibile della pagina stessa. Tuttavia, l’indice conserva un vettore per ogni patch nell’ordine di scansione raster, e ogni vettore è calcolato da un modello visione-linguaggio preaddestrato a leggere documenti. Ipotizziamo quindi che chiunque gestisca o violi l’archivio possa riprodurre una pagina dal solo indice. Formuliamo l’inversione come generazione condizionata di immagini di documenti e ricaviamo dai vettori ciò che serve per l’attacco: l’encoder, la forma della pagina e, nel caso di vettori rimescolati, il loro ordine. Sul benchmark ViDoRe v3, le pagine ricostruite dagli indici grezzi recuperano il 47% delle parole e il 45% dei token sensibili. Usate come query sugli indici memorizzati, collocano la pagina da cui provengono al primo posto nel 98,4% dei casi. Testiamo due protezioni poco costose, il pooling dei token e il rimescolamento, che riducono entrambe il recall delle parole a circa l’8%. Un modello che ripristina l’ordine di un indice rimescolato porta dal 3,8% al 93,5% la quota di pagine di origine collocate al primo posto, mentre l’inversione di un indice sottoposto a pooling resta un problema aperto. Per verificare la generalizzazione, applichiamo lo stesso attacco, senza modifiche, a un altro sistema di recupero multi-vettoriale: le pagine ricostruite collocano ancora la pagina da cui provengono al primo posto nel 70,2% dei casi, anche se il recall delle parole rimane inferiore a quello di una baseline basata sui vicini più prossimi. I sistemi di recupero multi-vettoriali di documenti visivi sono quindi vulnerabili all’inversione attraverso l’indice memorizzato, che dovrebbe essere protetto come i documenti che codifica.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv