Ricerca
Il filo di Ariadne nel LipSync: smascherare le falsificazioni attraverso l’incoerenza tra movimenti labiali e pose della testa
I recenti progressi nelle tecnologie di generazione LipSync hanno reso possibile creare video altamente realistici, con gravi rischi per la società. Le strategie di difesa esistenti, tuttavia, fatican
- arXiv
- 2610.08417
- Pubblicato
- 2026-10-06
- Autori
- Tianyi She, Jiawei Liu, Weifeng Liu, Hanqing Zhao, Weiming Zhang, Kejiang Chen
Abstract degli autori
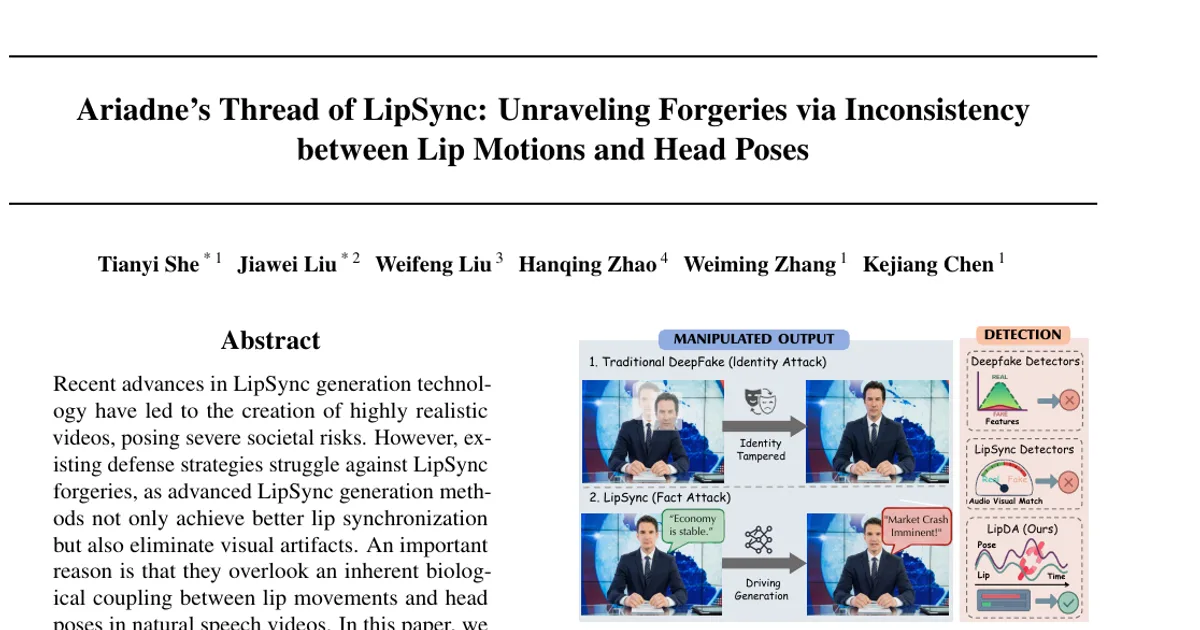
I recenti progressi nelle tecnologie di generazione LipSync hanno reso possibile creare video altamente realistici, con gravi rischi per la società. Le strategie di difesa esistenti, tuttavia, faticano a contrastare le falsificazioni LipSync: i metodi di generazione più avanzati non solo sincronizzano meglio le labbra, ma eliminano anche gli artefatti visivi. Una ragione importante è che queste strategie trascurano il legame biologico intrinseco tra movimenti labiali e pose della testa nei video di persone che parlano naturalmente. In questo articolo proponiamo LipDA, un nuovo framework per il rilevamento e l’attribuzione congiunti delle falsificazioni LipSync, che sfrutta l’incoerenza tra testa e labbra. Per il rilevamento, il framework impara a quantificare questa discrepanza confrontando le caratteristiche delle labbra e delle pose nei video autentici e in quelli falsificati. Per l’attribuzione, il nostro metodo è progettato per cogliere le dinamiche temporali e gli schemi di sincronizzazione audiovisiva peculiari che fungono da impronta digitale dei modelli, consentendo di risalire alla fonte. Abbiamo condotto esperimenti approfonditi su due impegnativi dataset LipSync e su un dataset di ampia scala, basato su più generatori, che abbiamo proposto noi stessi. LipDA ottiene un’AUC superiore al 97\% nel rilevamento e un’accuratezza del 97,5\% nell’attribuzione del modello, superando nettamente i metodi esistenti. Il codice e il dataset LipSync-A proposto sono disponibili all’indirizzo https://github.com/AnsonShe/LipDA.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv