Ricerca
GTR: Gated Token Recurrence per una predizione densa efficiente
I backbone per la visione basati sulla self-attention ottengono buoni risultati nella predizione densa, ma il costo computazionale quadratico della softmax attention globale ne limita l’efficienza all
- arXiv
- 2609.26590
- Pubblicato
- 2026-09-22
- Autori
- Zhe Feng, Longfei Liu, Wei Liu, Kai Chen, Jiangang Kong, Wei Zhou, Yifeng Qian, Dexiong Chen, Xuanlong Yu, Xi Shen
Abstract degli autori
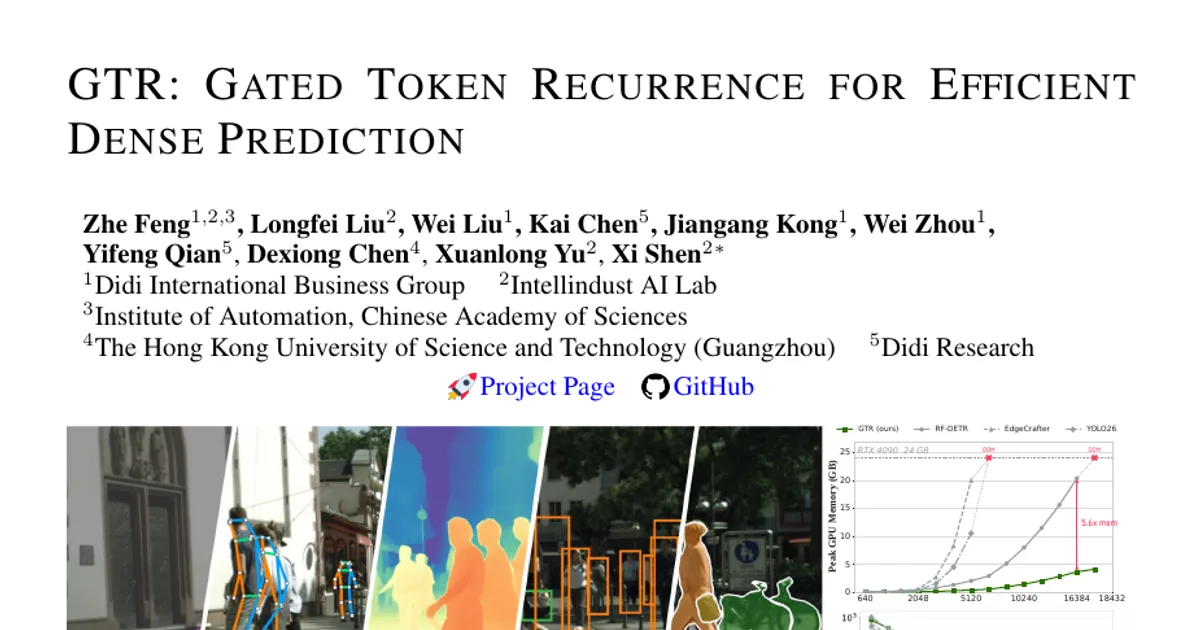
I backbone per la visione basati sulla self-attention ottengono buoni risultati nella predizione densa, ma il costo computazionale quadratico della softmax attention globale ne limita l’efficienza all’aumentare della risoluzione delle immagini. Presentiamo Gated Token Recurrence (GTR), un backbone ricorrente per la visione privo di softmax che combina attenzione lineare con gating, direzioni alternate di scansione spaziale e blocchi SwiGLU con potenziamento spaziale. GTR viene addestrato mediante distillazione da un modello teacher DINOv3 specializzato nel rilevamento, usando soltanto l’allineamento dei patch token dell’ultimo livello tramite una proiezione lineare e una funzione di perdita $\ell_2$ al quadrato, senza predizione di token mascherati né supervisione dei livelli intermedi. Con il pre-addestramento del rilevatore su Objects365, GTR-L raggiunge un box AP di 58,9 su COCO \texttt{val2017}, con una latenza mediana di 1,908\,ms per batch di dimensione uno, in esecuzione FP16 compilata su una RTX~4090. Lo stesso backbone si trasferisce anche alla segmentazione delle istanze, alla stima della posa, al rilevamento orientato, alla segmentazione semantica e alla stima della profondità monoculare. In un benchmark isolato del kernel, il nostro operatore CUDA specializzato, che elabora i dati per blocchi, è $4.0\times$ più veloce di FLA v0.5.0 con 1,6K token su RTX~4090. L’implementazione con TensorRT su DRIVE AGX Thor raggiunge una latenza mediana di 2,282--8,769\,ms per batch di dimensione uno sui modelli valutati. Questi risultati mostrano che la combinazione ricorrente dei token può offrire un’alternativa efficiente alla softmax attention globale per la predizione densa ad alta risoluzione e l’implementazione su dispositivi edge. Pagina del progetto: https://intellindust-ai-lab.github.io/projects/GTR/
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv