Ricerca
Decentralized Master-Mind: affinamento delle azioni congiunte mediante rimozione iterativa del rumore dalle intenzioni nella ricerca di percorsi multiagente
Nella ricerca decentralizzata di percorsi multiagente (MAPF) con comunicazione, gli agenti devono raggiungere ciascuno il proprio obiettivo senza collisioni, in condizioni di osservabilità parziale. L
- arXiv
- 2609.32019
- Pubblicato
- 2026-09-25
- Autori
- Valeriy Vyaltsev, Anton Andreychuk, Taisia Zlotnikova, Konstantin Yakovlev, Aleksandr Panov, Alexey Skrynnik
Abstract degli autori
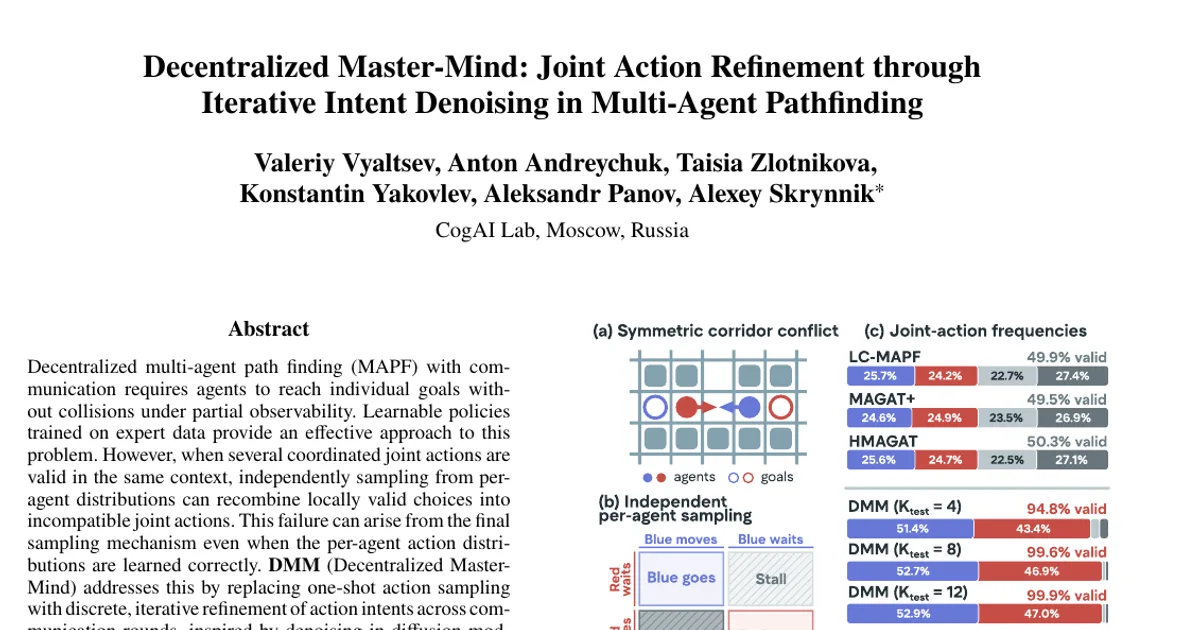
Nella ricerca decentralizzata di percorsi multiagente (MAPF) con comunicazione, gli agenti devono raggiungere ciascuno il proprio obiettivo senza collisioni, in condizioni di osservabilità parziale. Le politiche apprese da dati forniti da esperti offrono un approccio efficace al problema. Tuttavia, quando nello stesso contesto sono valide diverse azioni congiunte coordinate, campionare indipendentemente dalle distribuzioni dei singoli agenti può combinare scelte valide a livello locale in azioni congiunte incompatibili. Il problema può dipendere dal meccanismo di campionamento finale anche quando le distribuzioni delle azioni dei singoli agenti sono apprese correttamente. DMM (Decentralized Master-Mind) lo affronta sostituendo il campionamento delle azioni in un’unica fase con un affinamento discreto e iterativo delle intenzioni d’azione attraverso più round di comunicazione, ispirato alla rimozione del rumore nei modelli di diffusione. Gli agenti inizializzano intenzioni d’azione casuali e le affinano tramite la comunicazione locale, coordinando le proprie scelte prima di renderle definitive. DMM viene preaddestrato tramite apprendimento per imitazione su soluzioni MAPF fornite da esperti e ulteriormente ottimizzato con MICPO, un metodo di apprendimento per rinforzo relativo al gruppo e privo di critic, progettato per affinare le azioni multiagente attraverso più round. In generale, DMM ottiene tassi di successo più elevati e costi delle soluzioni inferiori rispetto alle baseline basate sull’apprendimento valutate. Su 1.600 compiti MovingAI, DMM sottoposto a fine-tuning con MICPO ne risolve 1.598: è la copertura più alta tra i metodi valutati, con costi delle soluzioni vicini a quelli delle baseline migliori. DMM è inoltre in grado di gestire oltre un milione di agenti che agiscono contemporaneamente in ambienti ricchi di ostacoli. Questi risultati mostrano che affinare le intenzioni a livello di round può migliorare il coordinamento delle azioni congiunte preservando l’esecuzione decentralizzata.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv