Ricerca
Datare il modello: le date nascoste nei prompt di sistema influenzano la valutazione degli LLM
La riproducibilità è essenziale per la ricerca scientifica, eppure studi precedenti mostrano che gli output degli LLM variano a seconda dell’hardware e del raggruppamento in batch. Individuiamo un fat
- arXiv
- 2609.36931
- Pubblicato
- 2026-09-29
- Autori
- Mario Sanz-Guerrero, Minh Duc Bui, Manuel Mager, Katharina von der Wense
Abstract degli autori
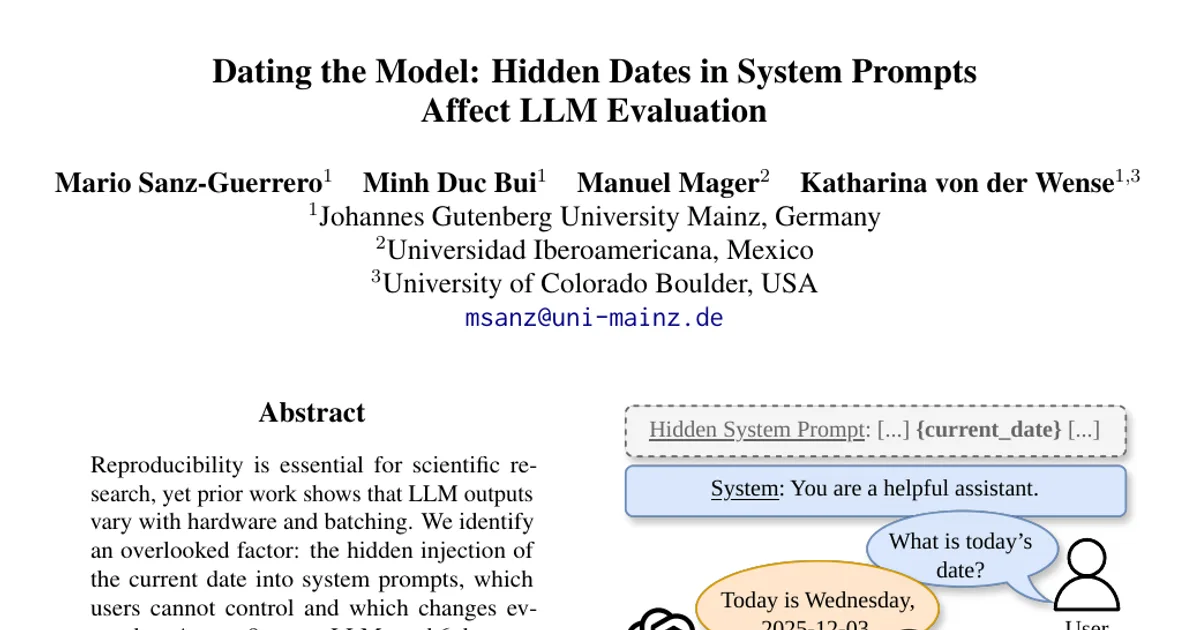
La riproducibilità è essenziale per la ricerca scientifica, eppure studi precedenti mostrano che gli output degli LLM variano a seconda dell’hardware e del raggruppamento in batch. Individuiamo un fattore finora trascurato: l’inserimento nascosto della data corrente nei prompt di sistema. Gli utenti non possono controllare questa data, che cambia ogni giorno. Su 9 LLM recenti e 6 dataset che comprendono domande a risposta multipla (MCQA), ragionamento matematico, generazione di codice e traduzione automatica, le prestazioni variano per effetto della sola data corrente, con differenze fino al 6% nelle MCQA, al 14% nel ragionamento matematico, al 7% nella generazione di codice e a 2,84 BLEU nella traduzione automatica. Cambiano anche le posizioni dei modelli, con ripercussioni sulle classifiche. L’effetto della data supera quello di altre fonti di non determinismo, come la dimensione dei batch e la precisione numerica. Le tecniche standard di prompting — chain-of-thought e prompting few-shot — non riducono questa sensibilità; il chain-of-thought, anzi, la amplifica. I nostri risultati sottolineano la necessità di protocolli di valutazione accurati per garantire la riproducibilità e confronti equi nella ricerca sugli LLM.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv