Ricerca
Attenzione continua
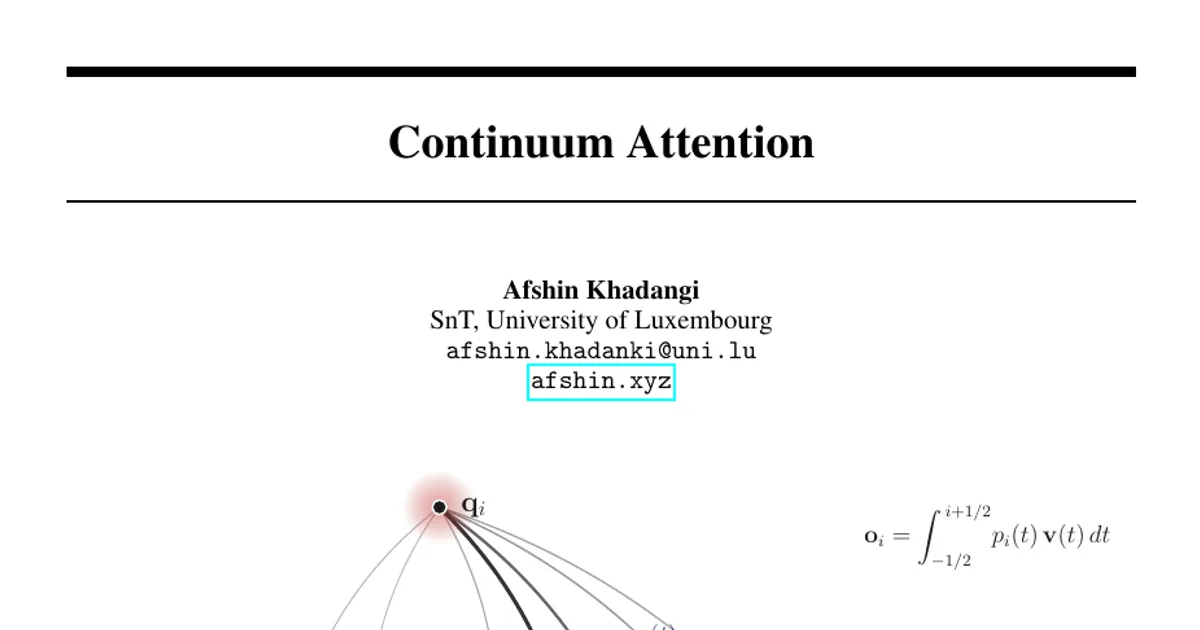
Presentiamo Continuum Attention (CA), un operatore di attenzione causale per Transformer che sostituisce la ricerca discreta di chiavi e valori con l’integrazione lungo una curva di memoria continua e
- arXiv
- 2610.20586
- Pubblicato
- 2026-10-14
- Autori
- Afshin Khadangi
Abstract degli autori
Presentiamo Continuum Attention (CA), un operatore di attenzione causale per Transformer che sostituisce la ricerca discreta di chiavi e valori con l’integrazione lungo una curva di memoria continua e lineare a tratti. Ogni query induce una densità esponenziale di rilevanza lungo la curva. L’integrazione della densità e dei valori interpolati produce un’attenzione normalizzata esatta a partire da momenti esponenziali in forma chiusa, inclusi i contributi di mezzo token ai confini. I gradienti si ricavano analiticamente da momenti di ordine non superiore a due, consentendo implementazioni parallele su GPU pur mantenendo la complessità quadratica rispetto alla lunghezza della sequenza e il decoder Transformer standard. Rispetto alla normale attenzione softmax e all’attenzione focale, CA riduce la log-verosimiglianza negativa media sul set di validazione rispettivamente di 0,0200 e 0,0480 nat per byte, risultando superiore in tutti i confronti a coppie. Su un’ulteriore porzione distinta del set di validazione, ottiene un vantaggio di 0,0457 nat per byte rispetto alla più forte baseline softmax selezionata, con un intervallo di confidenza al 95% per dati appaiati. Questi risultati indicano che l’integrazione continua è una promettente alternativa per l’attenzione, mentre resta aperta la questione della generalizzazione su scala più ampia.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv