Ricerca
Conditional Trajectory Peaks: policy multimodali in un solo passaggio su segmenti di azioni
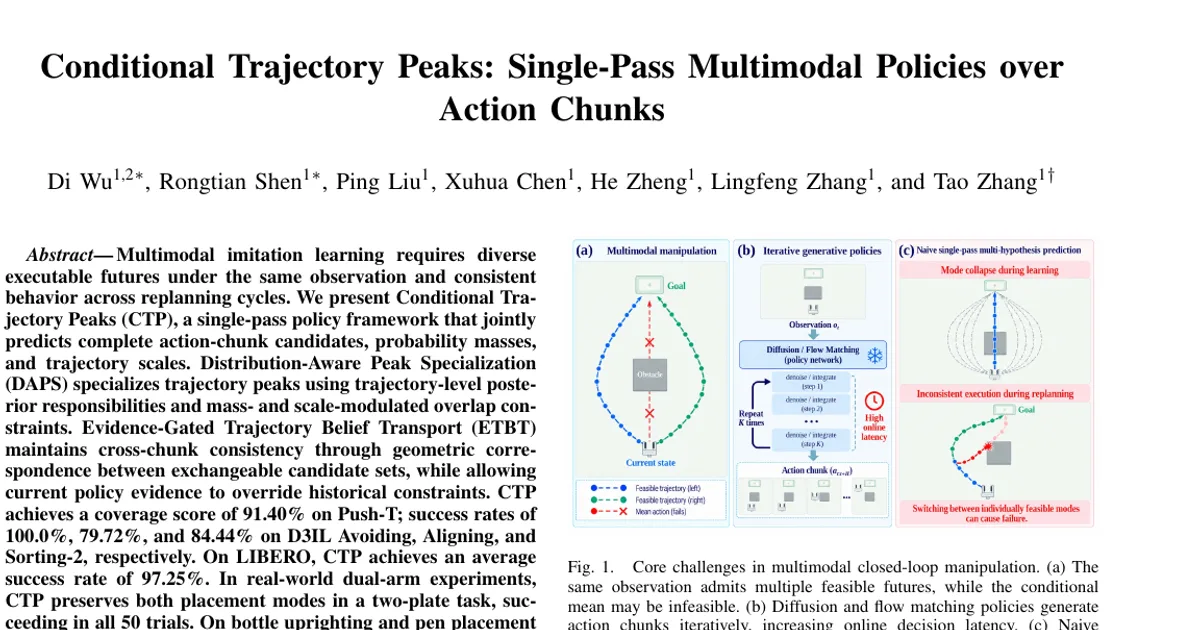
L’apprendimento per imitazione multimodale richiede diversi sviluppi futuri eseguibili a partire dalla stessa osservazione e un comportamento coerente tra i cicli di ripianificazione. Presentiamo Cond
- arXiv
- 2610.06104
- Pubblicato
- 2026-10-05
- Autori
- Di Wu, Rongtian Shen, Ping Liu, Xuhua Chen, He Zheng, Lingfeng Zhang, Tao Zhang
Abstract degli autori
L’apprendimento per imitazione multimodale richiede diversi sviluppi futuri eseguibili a partire dalla stessa osservazione e un comportamento coerente tra i cicli di ripianificazione. Presentiamo Conditional Trajectory Peaks (CTP), un framework per policy che, in un solo passaggio, predice congiuntamente candidati costituiti da segmenti completi di azioni, masse di probabilità e scale delle traiettorie. Distribution-Aware Peak Specialization (DAPS) specializza i picchi delle traiettorie usando responsabilità a posteriori a livello di traiettoria e vincoli di sovrapposizione modulati dalla massa e dalla scala. Evidence-Gated Trajectory Belief Transport (ETBT) mantiene la coerenza tra segmenti di azioni tramite una corrispondenza geometrica tra insiemi intercambiabili di candidati, consentendo al tempo stesso alle evidenze fornite dalla policy corrente di prevalere sui vincoli storici. CTP ottiene un punteggio di copertura del 91,40% su Push-T e tassi di successo rispettivamente del 100,0%, 79,72% e 84,44% su D3IL Avoiding, Aligning e Sorting-2. Su LIBERO, CTP raggiunge un tasso di successo medio del 97,25%. In esperimenti nel mondo reale con due bracci robotici, CTP mantiene entrambe le modalità di posizionamento in un compito con due piatti, riuscendo in tutte le 50 prove. Nel raddrizzamento di una bottiglia e nell’inserimento di una penna in un supporto, mantiene tassi di successo paragonabili a quelli di $π_{0.5}$, riducendo al contempo la latenza di inferenza della policy da 218,24 ms a 75,80 ms. Questi risultati dimostrano che la modellazione delle traiettorie in un solo passaggio può combinare comportamento multimodale, coerenza a ciclo chiuso e inferenza efficiente.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv