Ricerca
AReA: attenzione a campo recettivo adattivo per Diffusion Transformer efficienti ad alta risoluzione
Generare immagini a risoluzioni superiori a quella di addestramento dei Diffusion Transformer (DiT) resta difficile: il numero di token cresce rapidamente con la risoluzione, l’attenzione completa div
- arXiv
- 2610.17227
- Pubblicato
- 2026-10-12
- Autori
- Javad Rajabi, Koorosh Roohi, David B. Lindell, Babak Taati
Abstract degli autori
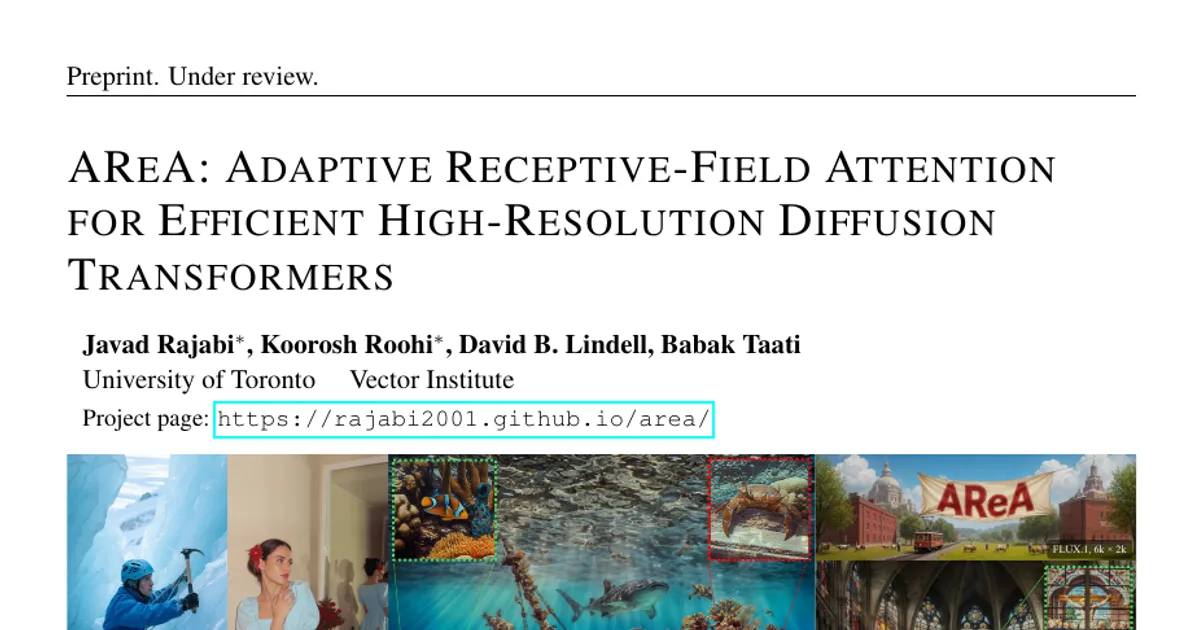
Generare immagini a risoluzioni superiori a quella di addestramento dei Diffusion Transformer (DiT) resta difficile: il numero di token cresce rapidamente con la risoluzione, l’attenzione completa diventa costosa e le immagini prodotte presentano spesso distorsioni strutturali e una perdita di dettaglio. Individuiamo nell’impiego uniforme dell’attenzione completa la causa comune dei due problemi. Prestare attenzione a tutti i token in ogni passaggio comporta un costo quadratico ed espone il modello a un numero maggiore di token e a distanze relative che superano l’intervallo incontrato durante l’addestramento, portandolo fuori distribuzione. Osserviamo che il campo recettivo effettivo dell’attenzione si restringe durante la rimozione del rumore: è globale nei primi passaggi, in cui si forma la struttura, e locale in quelli successivi, in cui si affinano i dettagli. Proponiamo AReA, un meccanismo di attenzione che non richiede addestramento e il cui campo recettivo passa dal generale al particolare, seguendo la progressione della rimozione del rumore. Nei primi passaggi, AReA applica un’attenzione a grana grossa tra scale diverse a chiavi e valori sottocampionati, acquisendo il contesto globale; nei passaggi successivi applica invece un’attenzione locale all’interno di finestre via via più piccole. Senza parametri aggiuntivi né addestramento, gli esperimenti mostrano che AReA supera sistematicamente i metodi di riferimento allo stato dell’arte che non richiedono addestramento, a diverse risoluzioni obiettivo e con modelli differenti, risultando anche più veloce ed efficiente.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv