Ricerca
Apprendere l’editing 3D senza supervisione su coppie tramite la distillazione di un prior generativo
L’editing 3D guidato da istruzioni è essenziale per la creazione interattiva di contenuti, ma deve fare i conti con un ostacolo significativo: la grave scarsità di coppie di dati di alta qualità per l
- arXiv
- 2609.04942
- Pubblicato
- 2026-09-04
- Autori
- Hao Wen, Weibin Yun, Hongxing Fan, Haotian Lu, Rui Chen, Zehuan Huang, Lu Sheng
Abstract degli autori
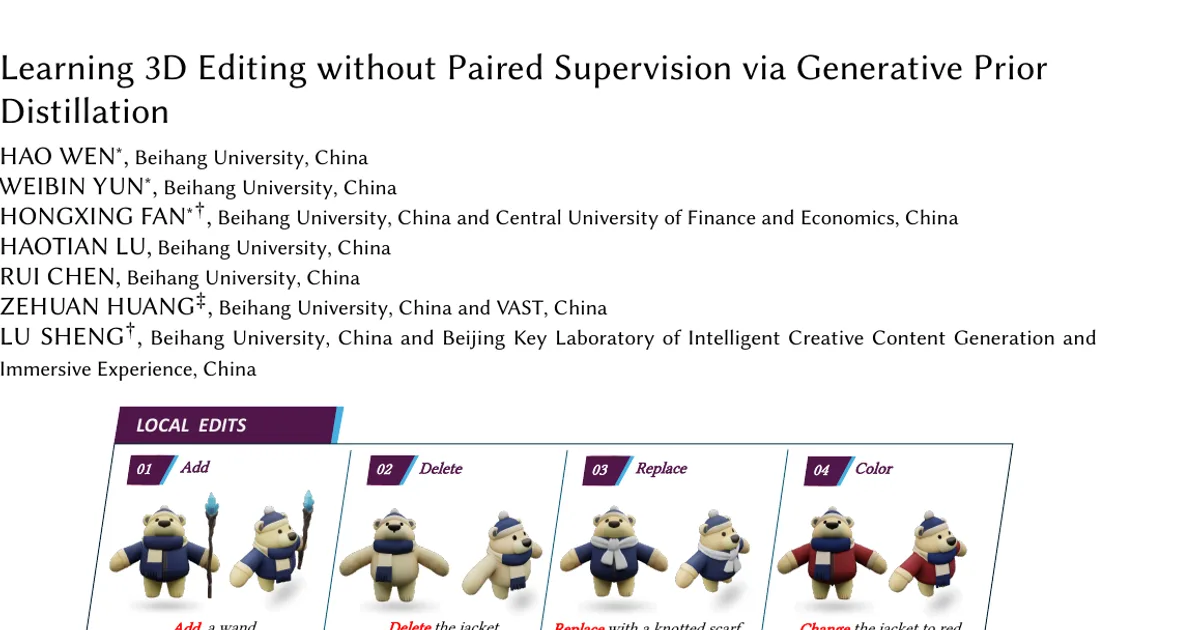
L’editing 3D guidato da istruzioni è essenziale per la creazione interattiva di contenuti, ma deve fare i conti con un ostacolo significativo: la grave scarsità di coppie di dati di alta qualità per l’addestramento. Gli approcci esistenti cercano di aggirarlo ricorrendo a una lenta ottimizzazione in fase di test oppure addestrando i modelli su pseudo-coppie costruite mediante pipeline complesse, che spesso introducono derive strutturali e artefatti geometrici. In questo articolo proponiamo un nuovo framework che apprende l’editing 3D feed-forward senza supervisione su coppie 3D, attraverso la distillazione di un prior generativo. Anziché basarci su coppie 3D di ground truth, distilliamo le conoscenze visive, semantiche e geometriche di potenti modelli di base direttamente in un modello di editing 3D. Nello specifico, attraverso una pipeline di rendering differenziabile, supervisioniamo la rappresentazione 3D con due segnali complementari: un prior visivo 2D proveniente da un modello di editing delle immagini, applicato alla vista principale di editing, e un prior semantico proveniente da un modello visivo-linguistico, applicato a nuove viste per garantire il rigoroso rispetto delle istruzioni e la preservazione dell’identità dell’originale. Per affrontare il collasso geometrico e le incoerenze tra viste insiti nella supervisione basata su proiezioni 2D, introduciamo inoltre una regolarizzazione tramite Distribution Matching che tiene conto del 3D. Questo termine funge da prior geometrico e opera nello spazio latente 3D, vincolando il risultato dell’editing a rimanere nella varietà di asset 3D realistici definita da un modello teacher preaddestrato per la conversione da immagini a 3D. Numerosi esperimenti dimostrano che il nostro metodo offre una fedeltà alle istruzioni e una coerenza tra viste superiori, superando nettamente i metodi di riferimento più avanzati. Il nostro progetto è disponibile all’indirizzo: https://github.com/thiamine128/PriorEdit3D.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv