Ricerca
ALPINE: localizzazione adattiva per un apprendimento a pochi esempi efficiente in termini di parametri e campioni
La ricerca sull’apprendimento a pochi esempi viene valutata prevalentemente in base alla sola accuratezza, con scarsa attenzione ai budget di parametri e di campioni di addestramento necessari per rag
- arXiv
- 2609.22323
- Pubblicato
- 2026-09-16
- Autori
- Neeraj Yadav
Abstract degli autori
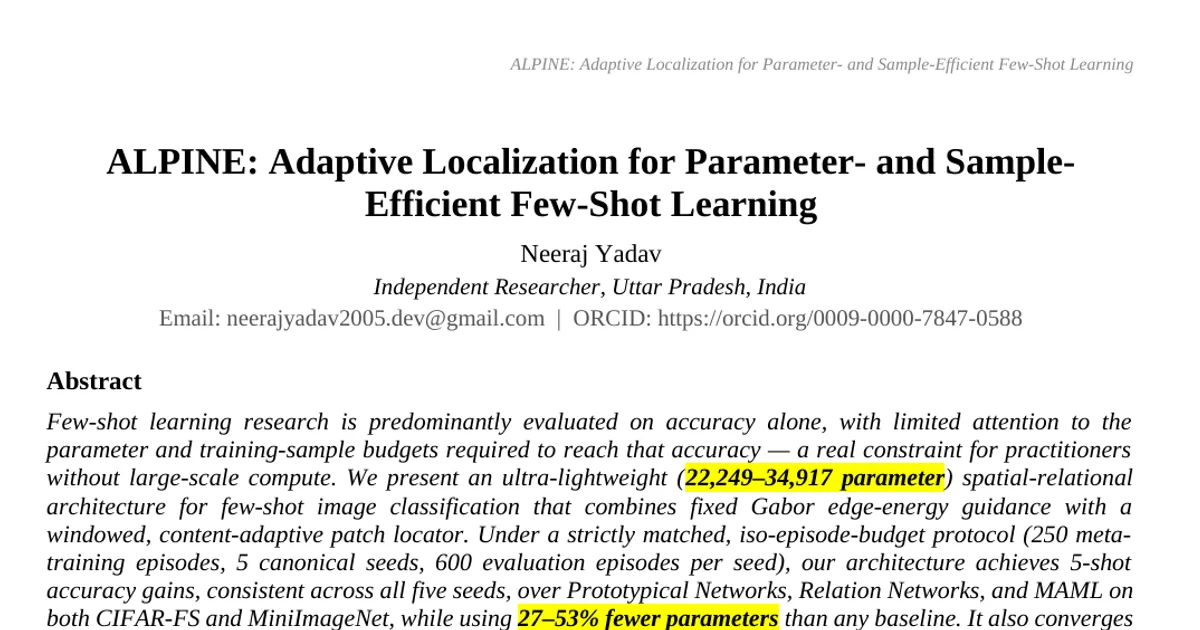
La ricerca sull’apprendimento a pochi esempi viene valutata prevalentemente in base alla sola accuratezza, con scarsa attenzione ai budget di parametri e di campioni di addestramento necessari per raggiungerla: un vincolo concreto per chi non dispone di risorse di calcolo su larga scala. Presentiamo un’architettura spaziale-relazionale ultraleggera (da 22.249 a 34.917 parametri) per la classificazione di immagini con pochi esempi, che combina una guida basata sull’energia dei bordi di Gabor fissa con un localizzatore di patch a finestre, adattivo al contenuto. In base a un protocollo rigorosamente comparabile, con lo stesso budget di episodi (250 episodi di meta-addestramento, 5 seed canonici e 600 episodi di valutazione per seed), la nostra architettura migliora l’accuratezza nel regime 5-shot, con risultati coerenti su tutti e cinque i seed, rispetto a Prototypical Networks, Relation Networks e MAML, sia su CIFAR-FS sia su MiniImageNet, utilizzando al contempo dal 27% al 53% di parametri in meno rispetto a qualsiasi baseline. Converge inoltre in meno episodi di addestramento, generalizza meglio a un dominio fine-grained mai visto prima (uccelli CUB-200-2011, senza riaddestramento) ed è più robusta di tutte e tre le baseline in presenza di un’occlusione del 50% e di una traslazione spaziale del 25%. Una serie di ablazioni volte a confutare il ruolo dei componenti — azzerando i token relazionali in fase di inferenza e riaddestrando completamente il modello senza di essi — mostra che il calcolo relazionale a coppie dell’architettura, pur essendo presente, non è il principale fattore alla base delle sue prestazioni: lo è invece il localizzatore di patch adattivo al contenuto. Riferiamo questi risultati con trasparenza, insieme a un’analisi della capacità che mostra un autentico plateau di accuratezza intorno ai 22-35 mila parametri, e pubblichiamo i risultati completi a livello di seed e gli hash dei checkpoint per garantire la riproducibilità.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv