Ricerca
Addestrare meglio, non di più: cambiare strategia di addestramento nell’apprendimento attivo in base a un segnale
La strategia di addestramento, ossia scegliere se riaddestrare il modello da zero o fare fine-tuning a partire dal checkpoint precedente, è una variabile decisionale trascurata nell’apprendimento atti
- arXiv
- 2609.06806
- Pubblicato
- 2026-09-06
- Autori
- Nagham Omar, Maya Rozenshtein, Evgeny Mishlyakov, Avigdor Gal
Abstract degli autori
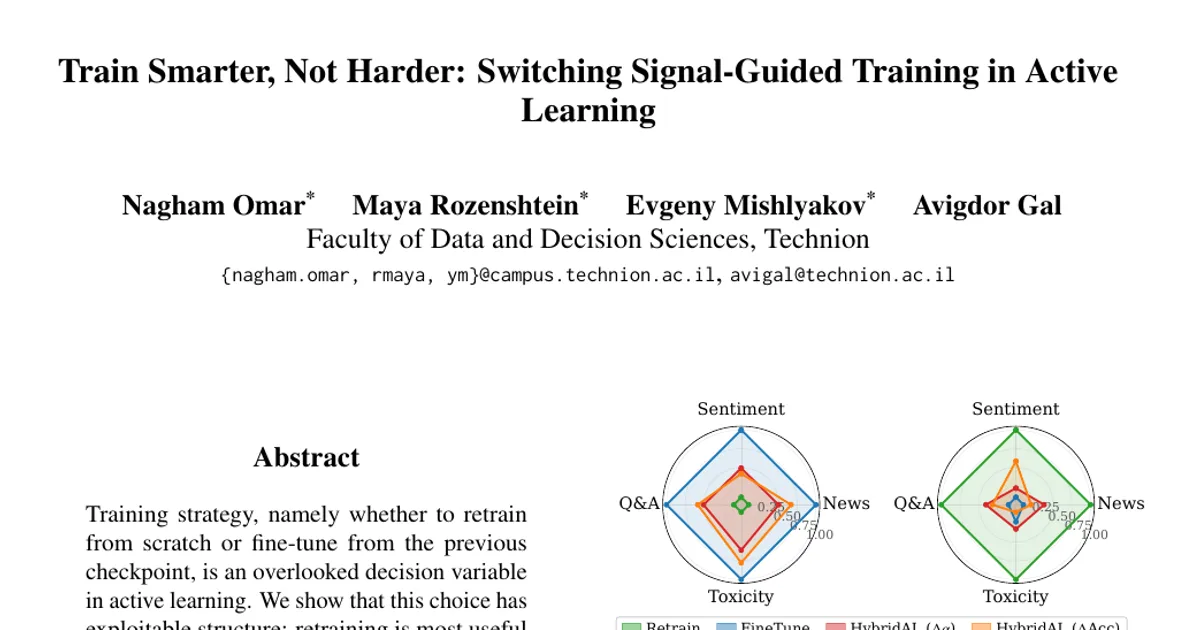
La strategia di addestramento, ossia scegliere se riaddestrare il modello da zero o fare fine-tuning a partire dal checkpoint precedente, è una variabile decisionale trascurata nell’apprendimento attivo. Mostriamo che questa scelta presenta una struttura sfruttabile: il riaddestramento è più utile nei primi cicli, quando ogni batch può modificare sensibilmente la distribuzione dei dati etichettati, mentre il fine-tuning diventa più sicuro una volta che la traiettoria del modello si stabilizza. Proponiamo HybridAL, un programma di addestramento adattivo che monitora un segnale di stabilizzazione online e passa dal riaddestramento al fine-tuning dopo un periodo di stabilizzazione prolungato. Due segnali complementari, la variazione dell’esponente spettrale $Δα$ (basata sui pesi) e la variazione dell’accuratezza $Δ$Acc (basata sulla validazione), coprono diversi punti del compromesso tra tempo e calibrazione. Su tre backbone encoder e sei compiti di classificazione del testo (con cinque seed ciascuno), HybridAL mantiene la macro-F1 finale non inferiore a quella del riaddestramento e del fine-tuning, con un margine di 0,010, risparmia fino al 49% del tempo di riaddestramento e recupera una parte considerevole del vantaggio di calibrazione del riaddestramento, misurato tramite la log-verosimiglianza negativa (NLL). Rispetto ai programmi che prevedono il passaggio a un ciclo fissato in anticipo, HybridAL ottiene una NLL inferiore a un costo aggiuntivo moderato, mostrando che cambiare strategia in base alla traiettoria offre un compromesso tra tempo e calibrazione migliore rispetto a un passaggio anticipato fissato in anticipo.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv