Ricerca
Basta uno sguardo: didascalie dettagliate per immagini in un solo passaggio con SimLoss
Un’immagine può valere mille parole, ma la maggior parte dei modelli che generano didascalie la descrive in poche. I moderni modelli visivo-linguistici producono didascalie scorrevoli che colgono gli
- arXiv
- 2609.00591
- Pubblicato
- 2026-09-01
- Autori
- Suryaansh Jain, Rahasya Barkur, Vishal G, Ryan Rossi, Franck Dernoncourt, Jack Wang, Koustava Goswami, Nedim Lipka, Puneet Mathur, Samyadeep Basu, Seunghyun Yoon
Abstract degli autori
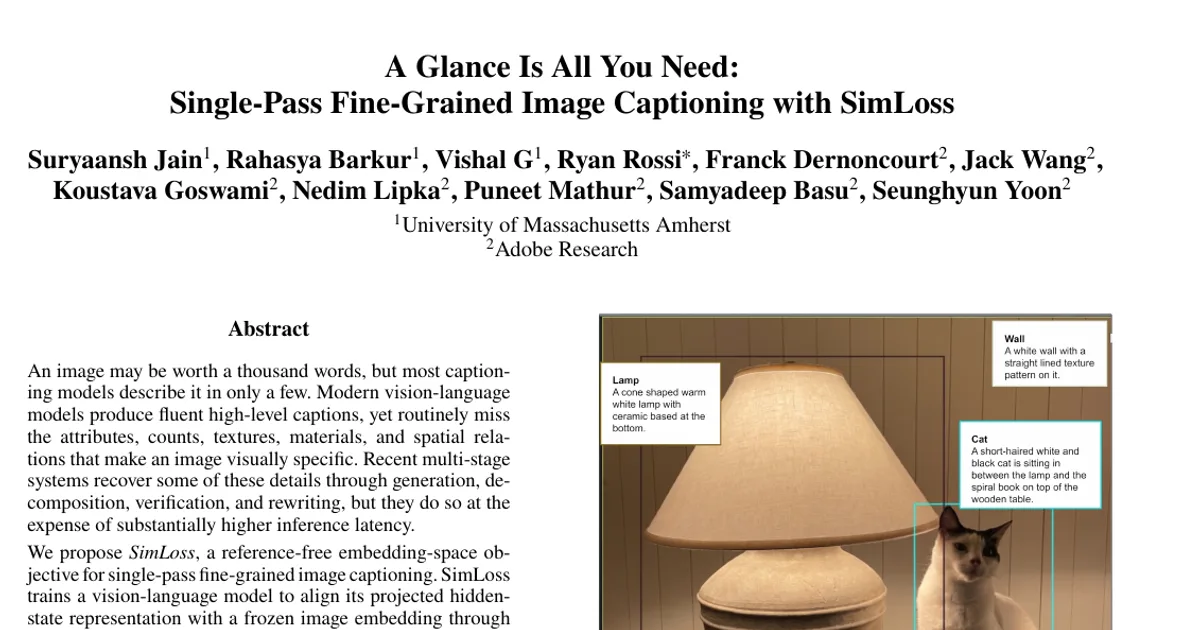
Un’immagine può valere mille parole, ma la maggior parte dei modelli che generano didascalie la descrive in poche. I moderni modelli visivo-linguistici producono didascalie scorrevoli che colgono gli aspetti generali, ma spesso tralasciano gli attributi, le quantità, le trame, i materiali e le relazioni spaziali che rendono un’immagine visivamente specifica. I recenti sistemi in più fasi recuperano alcuni di questi dettagli attraverso generazione, scomposizione, verifica e riscrittura, ma al prezzo di una latenza di inferenza nettamente più alta. Proponiamo SimLoss, una funzione obiettivo nello spazio degli embedding che non richiede riferimenti, per generare didascalie dettagliate in un solo passaggio. SimLoss addestra un modello visivo-linguistico ad allineare la rappresentazione proiettata dei suoi stati nascosti con un embedding dell’immagine congelato, mediante una funzione di perdita contrastiva InfoNCE. Fornisce così un segnale denso di supervisione visiva prima che venga decodificato qualsiasi testo, senza richiedere né didascalie dettagliate scritte da esseri umani né pseudo-didascalie prodotte da una pipeline in più fasi. Ne realizziamo due varianti: SimLoss FFT, che propaga il gradiente a ritroso attraverso un modello di embedding disponibile localmente, e SimLoss GRPO, che tratta quel modello come una ricompensa a scatola nera. Nel confronto con metodi di riferimento a passaggio singolo, con verifica in più fasi, ottimizzati per la ricompensa e attenti agli aspetti percettivi, la variante di fine-tuning completamente differenziabile, SimLoss FFT, ottiene la precisione più alta e quasi eguaglia il punteggio F1 del metodo in più fasi, mantenendo l’inferenza in un solo passaggio e funzionando circa 20 volte più velocemente della pipeline in più fasi. La variante basata sulla ricompensa, SimLoss GRPO, ottiene la recall più alta. Nel complesso, questi risultati mostrano che la supervisione nello spazio degli embedding può raggiungere la qualità della verifica in più fasi con la latenza di un sistema che genera didascalie in un solo passaggio.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv