The Pulse
Un team della UCLA testa il rilevamento ottico dei deepfake su 15 flussi video
Uno studio della UCLA descrive un sistema ibrido ottico-neurale che ha classificato 15 flussi video in parallelo, raggiungendo un’accuratezza media del 97,79% sul dataset di deepfake Celeb-DF. Il prototipo di laboratorio affianca l’elaboraz
AI.info Team · Scritto con l’IA ·
Pubblicato il 22 settembre 2026, uno studio della UCLA descrive un sistema ottico-neurale che ha classificato 15 flussi video in parallelo, raggiungendo un’accuratezza media del 97,79% sul dataset di deepfake Celeb-DF. Invece di far passare i video uno alla volta attraverso una rete di decodifica digitale, i ricercatori ne hanno codificato elettronicamente le caratteristiche, usando poi la luce che attraversa un apparato ottico fisico per produrre punteggi di autenticità.
Il risultato è una dimostrazione di laboratorio, non un rilevatore già pronto per esaminare i flussi video online. La fase ottica opera insieme all’elaborazione digitale convenzionale e le prestazioni variano a seconda dei dataset e delle configurazioni del sistema.
La luce gestisce la decodifica in parallelo
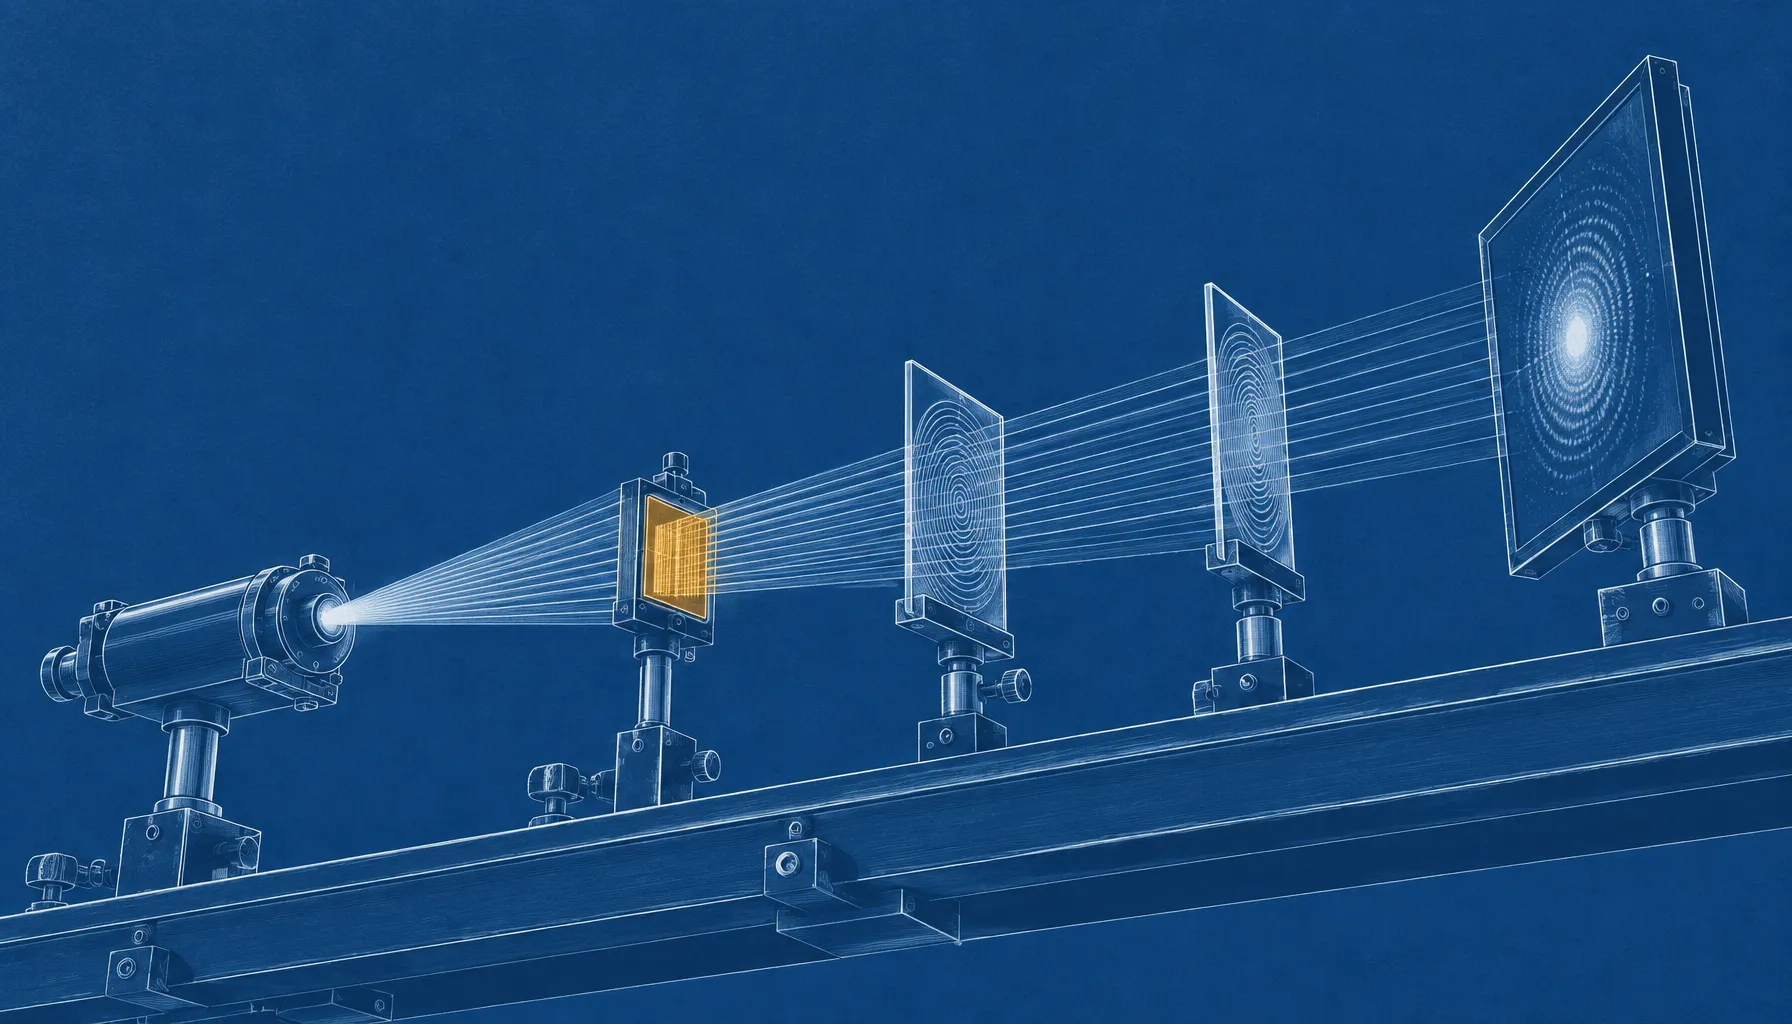
Il progetto del team combina una fase iniziale digitale con un decodificatore ottico a multiplexing spaziale. Un modulatore spaziale di luce programmabile codifica le informazioni di ciascun video in configurazioni luminose; queste si propagano attraverso l’apparato ottico e coppie di rilevatori registrano i segnali in uscita usati per classificare ogni video. Poiché i flussi occupano canali spaziali separati, un singolo passaggio ottico può elaborarne molti contemporaneamente.
«Il sistema di rilevamento ottico dei deepfake a multiplexing spaziale presentato è progettato per fungere da modulo di screening iniziale ad alta sensibilità ed efficiente dal punto di vista energetico per il rilevamento dei deepfake su larga scala». Gli autori dello studio, Parnian Ghapandar Kashani, Shiqi Chen e Aydogan Ozcan, scrivono che il loro progetto mira a segnalare i filmati sospetti per un’analisi digitale più approfondita, non a sostituire tale analisi.
L’accuratezza varia in base al dataset e al numero di canali
In un esperimento con luce visibile, il sistema ha elaborato 15 video di Celeb-DF per passaggio ottico, registrando un’accuratezza media del 97,79%, una sensibilità del 99,86% e una specificità del 95,72%. La sensibilità misura la frequenza con cui i video manipolati vengono correttamente segnalati; la specificità misura la frequenza con cui i video autentici vengono correttamente identificati. Le due misure descrivono rischi di errore diversi, quindi l’elevata sensibilità non significa che ogni video segnalato sia falso.
Quando i ricercatori hanno aumentato a 18 il numero di video elaborati in parallelo, l’accuratezza media è scesa al 96,13%. Attribuiscono il calo in parte all’aumento della diafonia ottica tra i canali. È un compromesso importante: concentrare più flussi in un singolo passaggio aumenta la capacità di elaborazione, ma il sistema testato non ha mantenuto la stessa accuratezza misurata con il numero maggiore di flussi.
Il team ha testato anche video generati con Veo 3 di Google tramite Gemini. Dopo il fine-tuning dell’encoder digitale con 50 video generati, il sistema sperimentale ha raggiunto un’accuratezza del 94,80%, una sensibilità del 97,61% e una specificità del 92,00% su un insieme di test tenuto da parte. Cinque video per il fine-tuning hanno prodotto un’accuratezza dell’85,1% nei test numerici, mentre la configurazione con 50 video ha prodotto il risultato sperimentale riportato.
Il confronto energetico riguarda il decodificatore
Lo studio confronta il decodificatore ottico con alternative digitali e stima il consumo energetico per video. In uno dei confronti, il decodificatore ottico a 15 canali con due strati diffrattivi passivi ha consumato, secondo le stime, da 1,38 a 4,11 millijoule per video; un decodificatore digitale convoluzionale profondo con prestazioni di rilevamento simili ne ha consumati 30,44. Questi dati riguardano il decodificatore, non l’intero processo: la preelaborazione e la codifica digitale dei video restano parte del sistema.
Questa distinzione è importante perché l’hardware ottico non elimina l’elaborazione convenzionale. I ricercatori descrivono il rilevamento dei volti, la localizzazione dei punti di riferimento facciali e la codifica delle caratteristiche come passaggi digitali che precedono la decodifica ottica. Il loro confronto energetico dipende inoltre dalle configurazioni scelte e dalle ipotesi sperimentali, anziché basarsi su un test diretto di un servizio di moderazione completo e operativo.
Una fase di screening, non un verdetto
I ricercatori propongono il sistema come filtro iniziale per lo screening di grandi volumi di video. I filmati che ricevono punteggi sospetti potrebbero poi essere esaminati ulteriormente da rilevatori digitali più impegnativi dal punto di vista computazionale. Questa configurazione potrebbe essere utile quando molti flussi richiedono un controllo preliminare, ma lo studio non ne dimostra le prestazioni con tutti i generatori di video, su tutte le piattaforme o in tutte le condizioni operative reali.
I risultati mostrano invece ciò che il prototipo ha dimostrato: l’hardware a luce visibile classifica 15 flussi di Celeb-DF in un solo passaggio, con un’accuratezza inferiore a 18 flussi e un risultato separato del 94,80% su video generati con Veo 3 e tenuti da parte per il test dopo il fine-tuning. Il decodificatore ottico fornisce la fase parallela; l’elaborazione digitale continua a preparare i video e a produrre le caratteristiche di cui ha bisogno.