Ricerca
WebFovea: quando il modello ha ragione ma il clic è sbagliato — interazioni affidabili di andata e ritorno per agenti web basati sulla visione su siti attivi
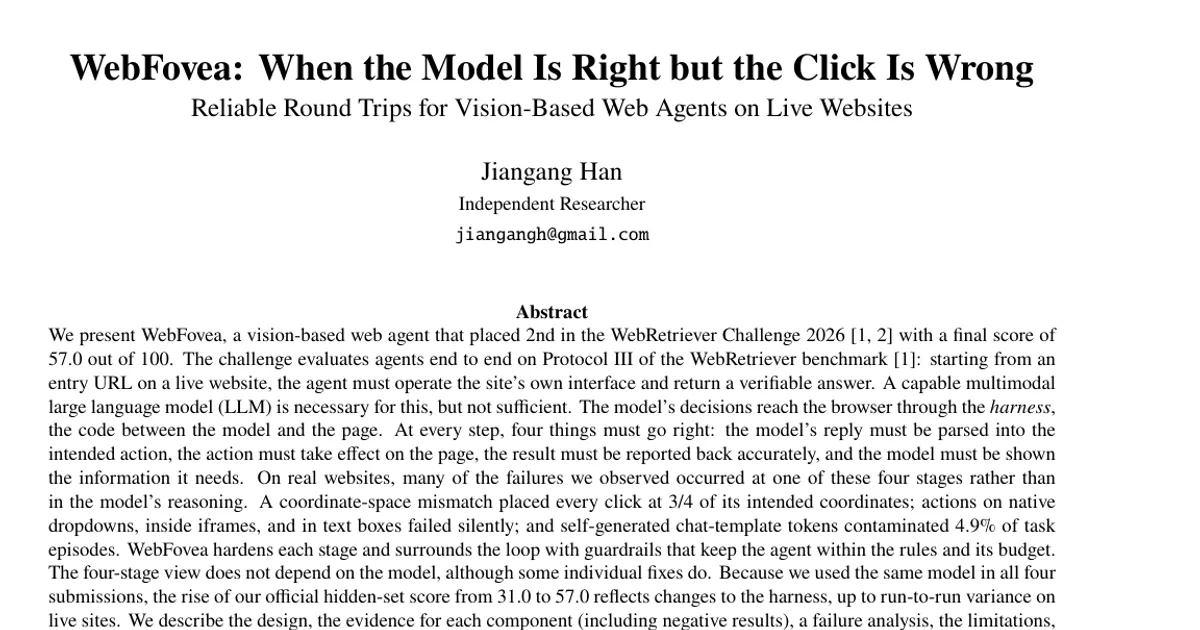
Presentiamo WebFovea, un agente web basato sulla visione che si è classificato al 2° posto nella WebRetriever Challenge 2026, con un punteggio finale di 57,0 su 100. La sfida valuta gli agenti dall’in
- arXiv
- 2610.03036
- Pubblicato
- 2026-10-02
- Autori
- Jiangang Han
Abstract degli autori
Presentiamo WebFovea, un agente web basato sulla visione che si è classificato al 2° posto nella WebRetriever Challenge 2026, con un punteggio finale di 57,0 su 100. La sfida valuta gli agenti dall’inizio alla fine sul Protocol III del benchmark WebRetriever (arXiv:2607.06118): partendo dall’URL di accesso a un sito attivo, l’agente deve usare l’interfaccia del sito stesso e restituire una risposta verificabile. Per farlo serve un modello linguistico di grandi dimensioni (LLM) multimodale e capace, ma non basta. Le decisioni del modello arrivano al browser attraverso l’harness, il codice che si interpone tra il modello e la pagina. A ogni passaggio devono funzionare quattro cose: la risposta del modello deve essere interpretata come l’azione prevista, l’azione deve produrre il suo effetto sulla pagina, il risultato deve essere comunicato correttamente al modello e al modello devono essere mostrate le informazioni di cui ha bisogno. Sui siti web reali, molti dei problemi che abbiamo osservato si sono verificati in una di queste quattro fasi, anziché nel ragionamento del modello. Una discrepanza tra sistemi di coordinate ha collocato ogni clic ai 3/4 delle coordinate previste; le azioni sui menu a discesa nativi, all’interno degli iframe e nelle caselle di testo sono fallite senza segnalare errori; e i token del template di chat autogenerati hanno contaminato il 4,9% degli episodi di esecuzione dei compiti. WebFovea rende più robusta ciascuna fase e aggiunge al ciclo misure di salvaguardia che mantengono l’agente entro le regole e il budget. Questa suddivisione in quattro fasi non dipende dal modello, anche se alcune singole correzioni sì. Poiché abbiamo usato lo stesso modello in tutte e quattro le candidature, l’aumento del nostro punteggio ufficiale sul set nascosto da 31,0 a 57,0 riflette le modifiche all’harness, al netto della variabilità tra esecuzioni su siti attivi. Descriviamo la progettazione, le evidenze a sostegno di ciascun componente (compresi i risultati negativi), un’analisi dei problemi, i limiti e una tabella di marcia che prevede di assegnare passaggi diversi a modelli diversi.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv