Ricerca
WearableQA: un benchmark per il ragionamento sulla salute a partire da dati reali di dispositivi indossabili
I recenti progressi dei sensori indossabili consentono di monitorare continuamente segnali fisiologici e comportamentali, ma i benchmark esistenti valutano raramente se i sistemi di IA siano in grado
- arXiv
- 2609.05405
- Pubblicato
- 2026-09-04
- Autori
- Ji Soo Lee, Xilun Chen, Pierce Chuang, Ashish Shenoy, Jason Wei, Dohwan Ko, Hyunwoo J. Kim, Benoit Corda
Abstract degli autori
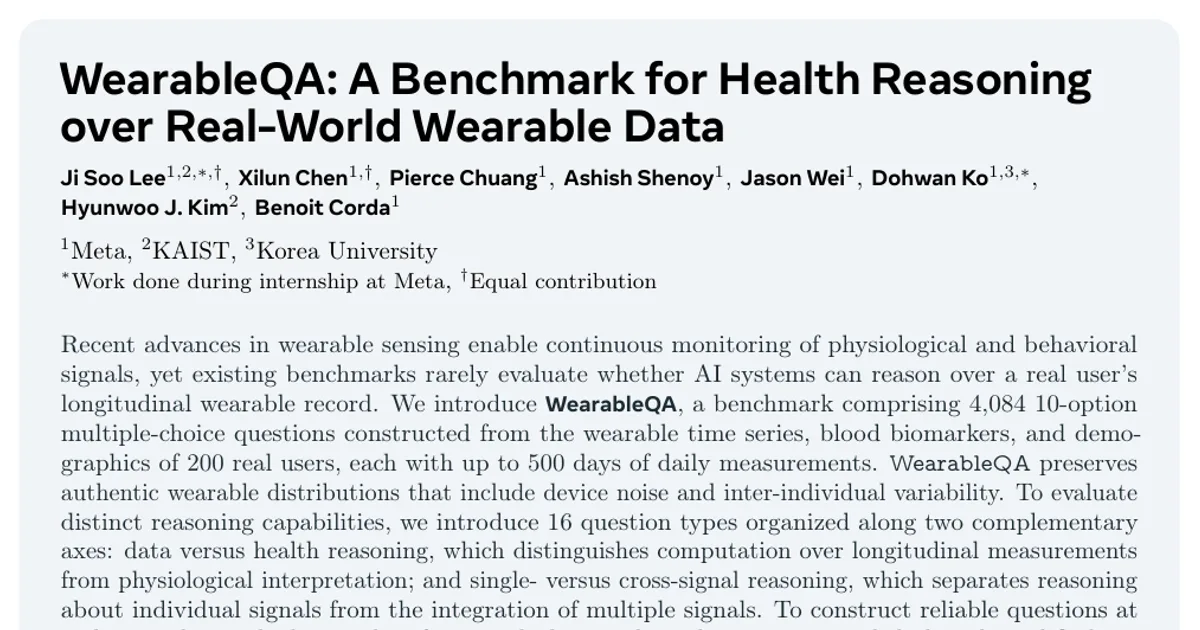
I recenti progressi dei sensori indossabili consentono di monitorare continuamente segnali fisiologici e comportamentali, ma i benchmark esistenti valutano raramente se i sistemi di IA siano in grado di ragionare sulla serie storica dei dati raccolti dai dispositivi indossabili di un utente reale. Presentiamo WearableQA, un benchmark composto da 4.084 domande a scelta multipla con 10 opzioni, costruite a partire dalle serie temporali dei dati raccolti dai dispositivi indossabili, dai biomarcatori ematici e dai dati demografici di 200 utenti reali, ciascuno con un massimo di 500 giorni di misurazioni quotidiane. WearableQA conserva le distribuzioni autentiche dei dati dei dispositivi indossabili, che includono il rumore dei dispositivi e la variabilità tra individui. Per valutare diverse capacità di ragionamento, introduciamo 16 tipi di domande organizzati lungo due assi complementari: il ragionamento sui dati rispetto a quello sulla salute, che distingue i calcoli sulle misurazioni longitudinali dall’interpretazione fisiologica; e il ragionamento su un singolo segnale rispetto a quello che coinvolge più segnali, che distingue il ragionamento sui singoli segnali dall’integrazione di più segnali. Per costruire domande affidabili su larga scala, adottiamo un quadro fondato su due basi: risultati fisiologici documentati nella letteratura e pattern fisiologici rilevati nella popolazione e convalidati statisticamente. Questo consente di cogliere relazioni significative osservate nei dati raccolti da dispositivi indossabili nel mondo reale. La valutazione di 14 LLM proprietari e open source dimostra che WearableQA distingue efficacemente le capacità dei modelli, con risultati che vanno dal 19,6% al 72,9%, a fronte di un livello di riferimento del 10% per le risposte casuali. Inoltre, WearableQA è ancora lontano dall’essere risolto: la maggior parte dei modelli raggiunge un’accuratezza inferiore al 60%. Nel complesso, WearableQA offre un benchmark realistico e diagnostico per valutare il ragionamento degli LLM sui dati raccolti da dispositivi indossabili nel mondo reale.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv