Ricerca
VeriFine: ampliare la verifica per l’auto-miglioramento nel ragionamento incarnato
Le policy che si migliorano autonomamente fanno emergere continuamente nuovi tipi di errore, modificando ciò che i valutatori devono essere in grado di verificare. Tuttavia, gli attuali valutatori fis
- arXiv
- 2610.08761
- Pubblicato
- 2026-10-06
- Autori
- Zewei Zhou, Rachel Luo, Yulong Cao, Chaowei Xiao, Chensheng Peng, Boyi Li, Thomas Tian, Zheng Lian, Yan Wang, Jiaqi Ma, Boris Ivanovic, Marco Pavone, Wenhao Ding
Abstract degli autori
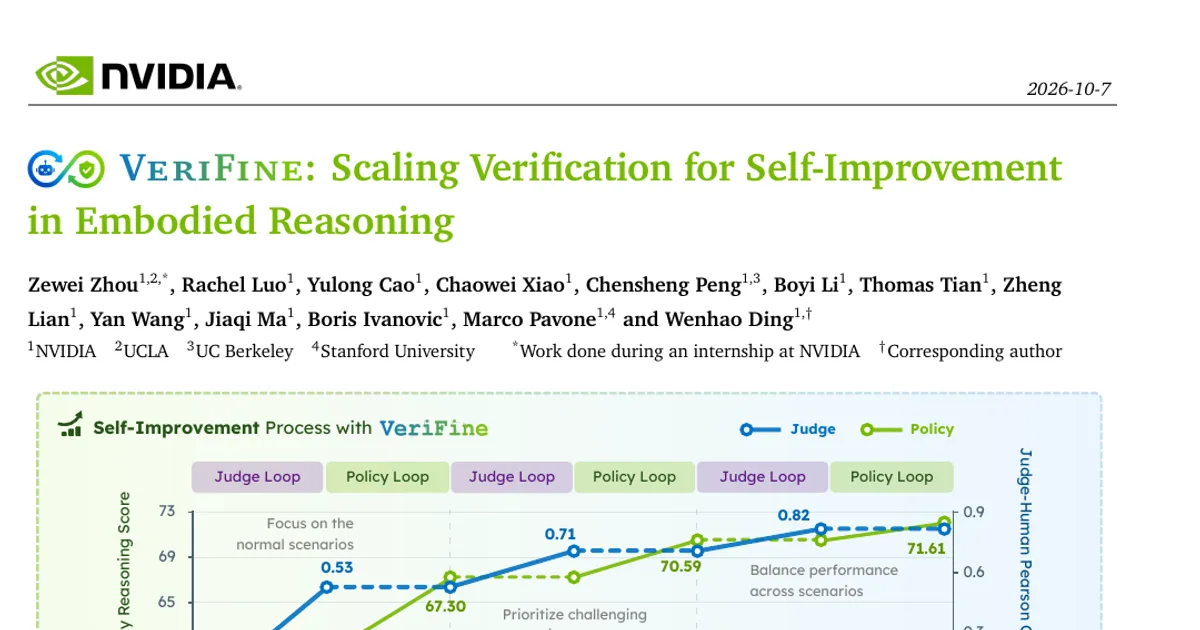
Le policy che si migliorano autonomamente fanno emergere continuamente nuovi tipi di errore, modificando ciò che i valutatori devono essere in grado di verificare. Tuttavia, gli attuali valutatori fissi limitano sia il feedback per l’ottimizzazione sia la scoperta di esempi utili per l’addestramento, frenando ulteriori miglioramenti autonomi. La sfida è ancora più difficile nel ragionamento incarnato, dove una valutazione affidabile deve tenere conto dell’ancoraggio spaziale, del ragionamento causale e delle decisioni attente alla sicurezza. Presentiamo VeriFine, un framework di supporto per agenti che amplia la capacità di verifica attraverso la coevoluzione della policy, del percorso di addestramento e del valutatore. Il Policy Improvement Loop usa un valutatore basato su una rubrica per individuare gli errori ricorrenti, costruire un percorso di addestramento adattivo e ottimizzare la policy. Quando i progressi si arrestano e la verifica diventa un collo di bottiglia, il Judge Improvement Loop richiede selettivamente indicazioni umane su casi di errore particolarmente informativi e affina il valutatore mediante una calibrazione coattiva, in cui esseri umani e agenti risolvono i disaccordi e convergono verso la rubrica oggettiva del ragionamento fisico. Il valutatore così aggiornato guida poi la fase successiva di selezione dei dati e ottimizzazione della policy. Esperimenti su compiti di guida e navigazione robotica mostrano un continuo miglioramento autonomo delle capacità sia della policy sia del valutatore, nell’apprendimento per rinforzo e nel fine-tuning supervisionato. Questi risultati mostrano come ampliare la capacità di verifica favorisca un miglioramento autonomo continuo mentre evolvono i tipi di errore della policy.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv