Ricerca
Vera memoria a lungo termine per l’IA: una finestra da 50 milioni di token più veloce e meno costosa del ricalcolo
Un modello linguistico di grandi dimensioni può usare solo il testo che rientra nella sua finestra di contesto e, ogni volta che riceve un prompt, ne ricalcola lo stato interno key-value (KV). Abbiamo
- arXiv
- 2610.10845
- Pubblicato
- 2026-10-07
- Autori
- Sietse Schelpe
Abstract degli autori
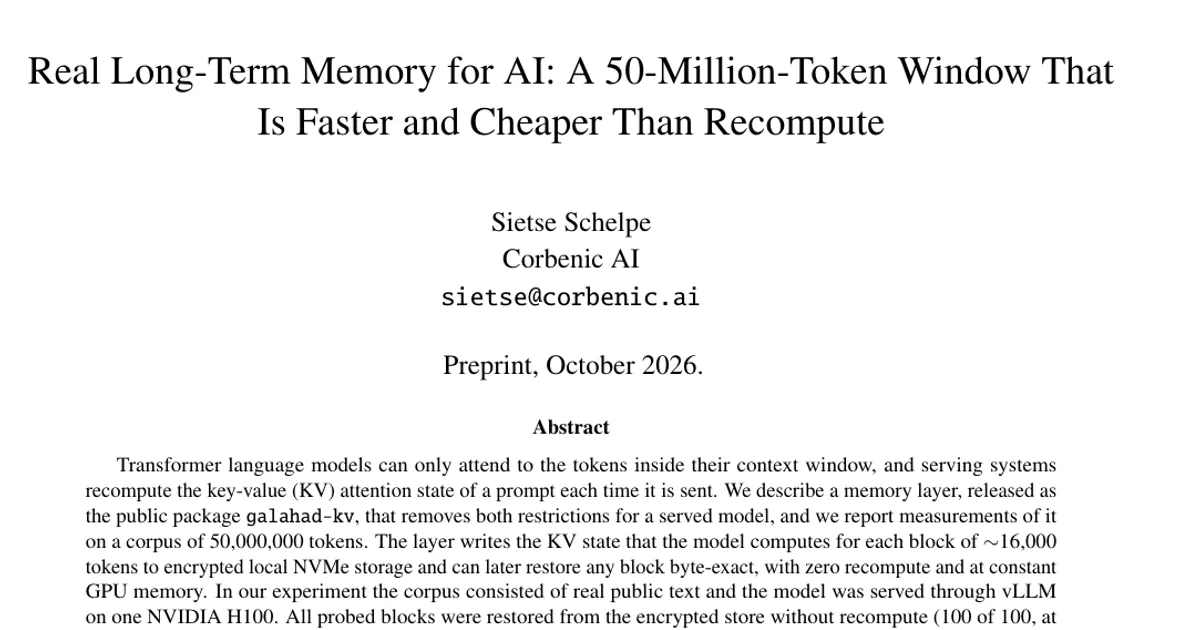
Un modello linguistico di grandi dimensioni può usare solo il testo che rientra nella sua finestra di contesto e, ogni volta che riceve un prompt, ne ricalcola lo stato interno key-value (KV). Abbiamo testato un livello di memoria, il pacchetto pubblico galahad-kv, che salva lo stato KV di ogni blocco di circa 16.000 token su un disco NVMe locale cifrato e lo ricarica in seguito, identico byte per byte, senza ricalcolarlo. Lo abbiamo testato su 50.000.000 di token di testi pubblici reali, serviti tramite vLLM su una sola NVIDIA H100, con Gemma 4 12B e Gemma 4 31B. Su entrambi i modelli, ogni blocco esaminato è stato ricaricato dall’archivio cifrato senza ricalcolo (100 su 100, a profondità comprese tra 0 e 50 milioni di token). Il caricamento di un blocco è stato da 2,8 a 4,3 volte più veloce del ricalcolo e ha consumato da 8,8 a 12,3 volte meno energia della GPU; l’uso della memoria della GPU è rimasto costante per l’intera sequenza di 50 milioni di token. Interrogato su fatti inseriti milioni di token prima, il modello 12B ha risposto correttamente 82 volte su 100 e il modello 31B 98 volte su 100. Nessuno dei due modelli ha inventato una risposta. I limiti sono i seguenti. Si tratta del riutilizzo di uno stato memorizzato, non di una finestra di attenzione più ampia: viene caricato un blocco alla volta e la qualità della risposta a una domanda dipende dal modello. La scrittura della memoria comporta un costo una tantum e l’archivio occupa terabyte di spazio su disco NVMe locale. Descriviamo il protocollo di test, progettato per resistere ai metodi comunemente usati per manipolare i benchmark sui contesti lunghi, e forniamo una procedura per riprodurre il test su una singola GPU usando software pubblico e una licenza gratuita per il pacchetto.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv