Ricerca
VDiff-Bench: un benchmark impegnativo per individuare differenze di dettaglio tra immagini
I modelli linguistici multimodali di grandi dimensioni (MLLM) ottengono buoni risultati in compiti generali di comprensione visiva, come rispondere a domande sulle immagini, ma spesso incontrano diffi
- arXiv
- 2609.06245
- Pubblicato
- 2026-09-05
- Autori
- Yixin Wan, Tianle Zheng, Kai-Wei Chang
Abstract degli autori
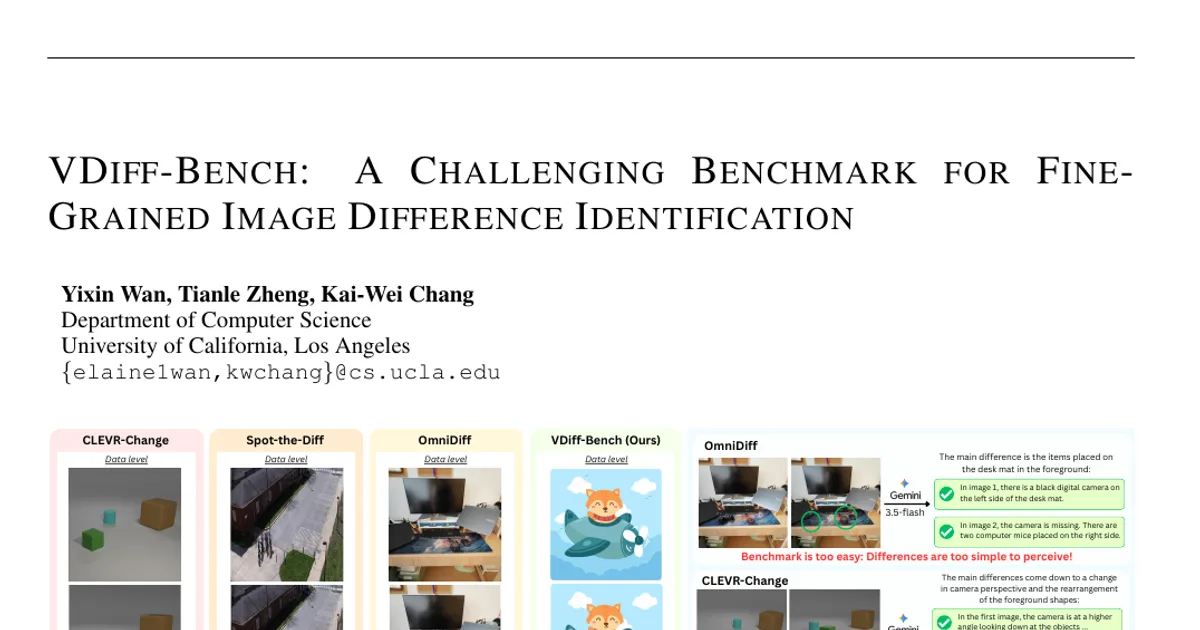
I modelli linguistici multimodali di grandi dimensioni (MLLM) ottengono buoni risultati in compiti generali di comprensione visiva, come rispondere a domande sulle immagini, ma spesso incontrano difficoltà in una capacità comparativa fondamentale: individuare che cosa è cambiato tra due immagini simili. Presentiamo VDiff-Bench, un benchmark impegnativo a scelta multipla per l’individuazione di differenze di dettaglio tra immagini. VDiff-Bench contiene 1.756 domande con quattro opzioni di risposta, basate su coppie di immagini, e copre 10 categorie di cambiamento: posizione, movimento, colore di una regione dell’immagine, colore complessivo dell’immagine, comparsa/scomparsa, rumore/risoluzione, texture, sostituzione/dimensioni, OCR/testo e illuminazione. Ogni domanda presenta due immagini in input e 4 opzioni: la differenza effettiva, due descrizioni errate ma difficili da escludere e l’opzione «nessuna differenza» come distrattore. Per rendere il compito impegnativo, selezioniamo appositamente opzioni errate in funzione della risposta corretta, che richiedono ai modelli di distinguere il cambiamento effettivo da alternative semanticamente vicine. Esperimenti condotti su 11 MLLM open source e closed source all’avanguardia mostrano che il confronto visivo di dettaglio rimane fragile: le prestazioni dei modelli variano a seconda delle fonti e delle categorie di cambiamento, con errori persistenti sui cambiamenti sottili di basso livello, come quelli relativi al rumore e alle texture. Per esempio, tre MLLM open source di scala 7-8B ottengono punteggi del 52,5-70,6% sui cambiamenti semantici, ma solo dell’8,7-33,3% sui cambiamenti di basso livello, come quelli relativi al rumore e alle texture, presumendo erroneamente che non vi siano differenze tra le due immagini in input. Sorprendentemente, nonostante le buone prestazioni degli altri modelli commerciali closed source, Grok 4.3 mostra un marcato calo delle prestazioni nell’individuare differenze di rumore e texture tra immagini, rimanendo nettamente indietro rispetto a grandi modelli open source come Kimi K2.5 e K3. Nel complesso, VDiff-Bench offre uno strumento diagnostico mirato per valutare la comprensione visiva comparativa degli MLLM, mettendo in luce errori che i compiti standard di visione e linguaggio basati su una singola immagine non rilevano.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv