Ricerca
Valutare i costi nascosti della personalizzazione nei modelli linguistici di grandi dimensioni
I modelli linguistici di grandi dimensioni (LLM) usano informazioni sugli utenti per migliorare la facilità d’uso e l’utilità delle risposte. Tuttavia, quando dispongono di un contesto personale, come
- arXiv
- 2608.28833
- Pubblicato
- 2026-08-28
- Autori
- Yumeng Wang, Yuchen Wu, Cheng Qian, Zhiyuan Fan, Hyeonjeong Ha, Shujin Wu, Jiayu Liu, Heng Ji, Ge Wang
Abstract degli autori
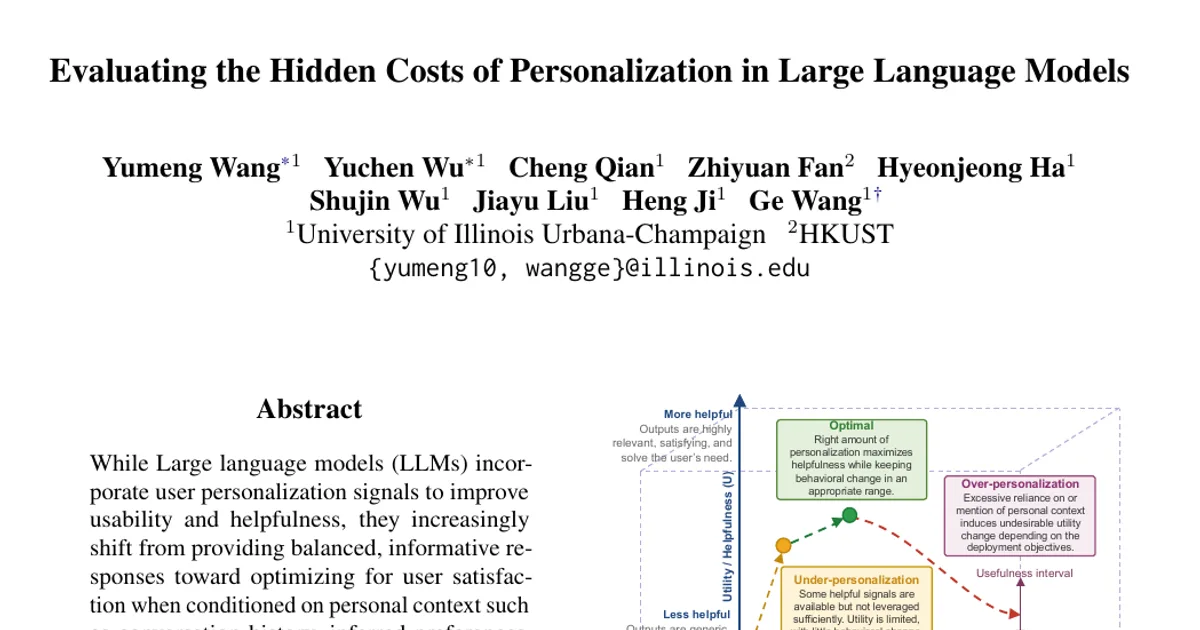
I modelli linguistici di grandi dimensioni (LLM) usano informazioni sugli utenti per migliorare la facilità d’uso e l’utilità delle risposte. Tuttavia, quando dispongono di un contesto personale, come la cronologia delle conversazioni, le preferenze dedotte e i profili degli utenti, tendono sempre più ad abbandonare risposte equilibrate e informative per puntare alla soddisfazione dell’utente. Individuiamo tre rischi emergenti: (1) la personalizzazione irrilevante, quando i modelli richiamano informazioni personali in contesti in cui non servono; (2) il restringimento delle preferenze, quando rafforzano le camere dell’eco informative; e (3) il bias adulatorio, quando concordano eccessivamente con le opinioni dell’utente. Di conseguenza, i modelli possono richiamare informazioni personali dove non è necessario, ridurre involontariamente la varietà delle risposte o concordare eccessivamente con le opinioni dell’utente. Nonostante l’uso crescente della personalizzazione negli assistenti di IA, i suoi potenziali effetti collaterali sono stati oggetto di poche valutazioni sistematiche. Per colmare questa lacuna, proponiamo PRISK, un sistema di valutazione dinamico che impiega la generazione automatica di dati e metriche su misura per mettere in luce i limiti sistematici della personalizzazione negli attuali LLM e il modo in cui le informazioni personalizzate ne influenzano le risposte. La nostra analisi empirica su 13 LLM mostra che la presenza di profili utente e memorie recuperate aggrava sistematicamente i bias, determinando un calo medio del 45,9% nella personalizzazione irrilevante, del 41,7% nel restringimento delle preferenze e del 61,7% nel bias adulatorio.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv