Ricerca
Insegnamento testuale universale per gli LLM
La distillazione della conoscenza (KD) trasferisce conoscenze da modelli Teacher più potenti a modelli Student meno potenti, ma la maggior parte dei metodi richiede di addestrare i parametri dello Stu
- arXiv
- 2610.12114
- Pubblicato
- 2026-10-08
- Autori
- Zhanyi Lu, Huan Wang
Abstract degli autori
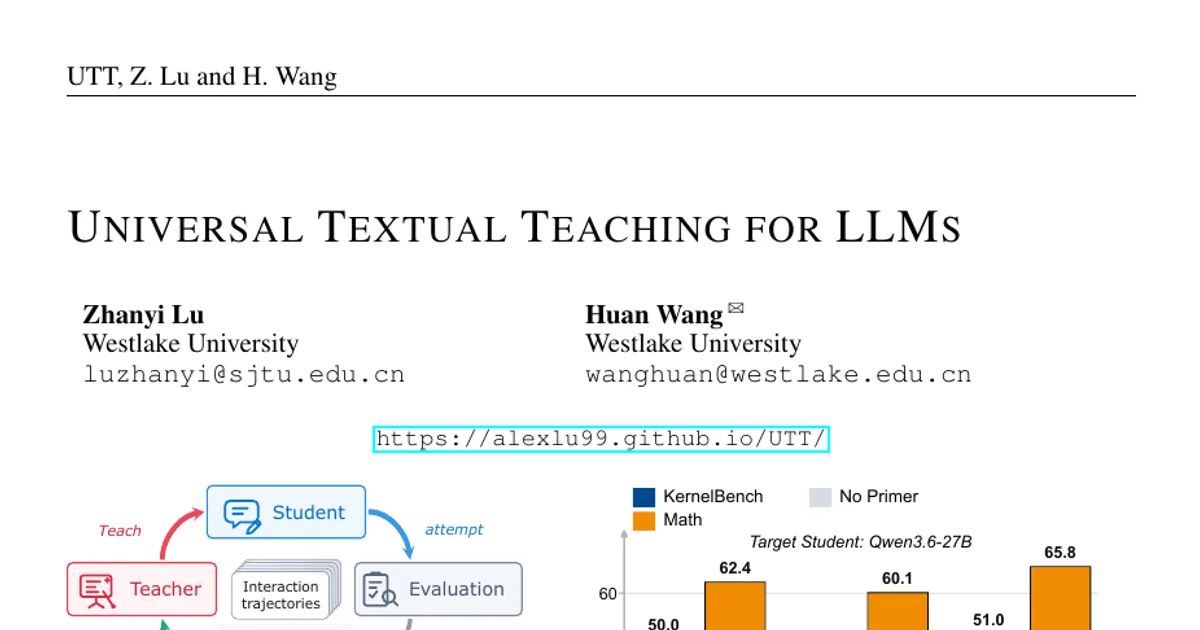
La distillazione della conoscenza (KD) trasferisce conoscenze da modelli Teacher più potenti a modelli Student meno potenti, ma la maggior parte dei metodi richiede di addestrare i parametri dello Student, legando così la conoscenza distillata a un’architettura e a un checkpoint specifici. Questa rappresentazione implicita è difficile da interpretare o riutilizzare tra modelli diversi e limita l’impiego della KD con modelli accessibili solo tramite API o costosi da addestrare. Questo lavoro studia il trasferimento di conoscenza per i modelli linguistici di grandi dimensioni (LLM). Presentiamo Universal Textual Teaching (UTT), un metodo che non richiede aggiornamenti dei parametri e distilla le lacune di conoscenza osservate tra Teacher e Student in un artefatto testuale in linguaggio naturale, interpretabile e riutilizzabile, chiamato Primer. Nello specifico, UTT individua dapprima casi rappresentativi di queste lacune mediante valutazioni appaiate, poi aggiorna iterativamente il Primer attraverso interazioni tra più ruoli: lo Student affronta ogni compito, il Prompter trasforma il feedback della valutazione in un’istruzione didattica, il Teacher fornisce una dimostrazione mirata e il Synthesizer riunisce gli insegnamenti convalidati. Su compiti impegnativi di matematica (Omni-MATH-2) e generazione di codice (KernelBench), gli ampi risultati sperimentali confermano l’efficacia del metodo: su KernelBench, UTT porta l’accuratezza dello Student dal 9,4% al 48,6% e l’accuratezza Fast1 dal 9% al 35%, mentre l’accuratezza nel ragionamento matematico sale dal 27,6% al 51,7%. UTT ottiene inoltre risultati migliori rispetto a metodi rappresentativi di ingegneria dei prompt e di KD basati sui parametri. UTT si dimostra inoltre generalizzabile a Teacher e Student diversi: un Primer elaborato per una coppia Teacher-Student può generalizzarsi ad altri Student che non hanno partecipato alla sua elaborazione.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv