Ricerca
TriWorldBench: una prospettiva di coerenza tra tre visuali sui modelli del mondo embodied
I modelli del mondo embodied prevedono gli esiti delle azioni dei robot per supportare l’apprendimento e la pianificazione. Per i robot dotati di telecamere sulla testa e sui polsi, servono visuali co
- arXiv
- 2609.26314
- Pubblicato
- 2026-09-22
- Autori
- Xuanyi Liu, Haofeng Wang, Ruiqi Li, Danni Yu, Rui Wan, Ruixu Zhang, Siyu Tao, Xue Yang, Shaofeng Zhang, Zicheng Zhang, Jiaqi Zhang, Siwei Ma
Abstract degli autori
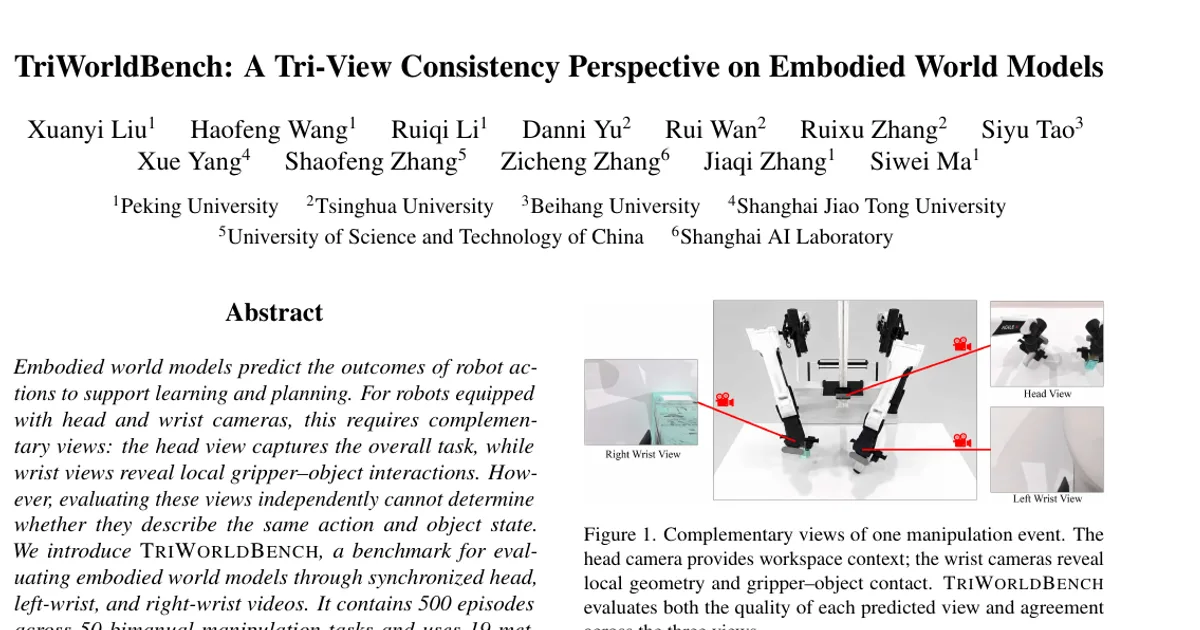
I modelli del mondo embodied prevedono gli esiti delle azioni dei robot per supportare l’apprendimento e la pianificazione. Per i robot dotati di telecamere sulla testa e sui polsi, servono visuali complementari: quella della testa mostra il compito nel suo insieme, mentre quelle dei polsi rivelano le interazioni locali tra pinza e oggetto. Tuttavia, valutare queste visuali in modo indipendente non permette di stabilire se descrivano la stessa azione e lo stesso stato dell’oggetto. Presentiamo TRIWORLDBENCH, un benchmark per valutare i modelli del mondo embodied attraverso video sincronizzati ripresi dalla testa, dal polso sinistro e dal polso destro. Comprende 500 episodi relativi a 50 compiti di manipolazione bimanuale e usa 19 metriche per valutare la coerenza tra le tre visuali, l’allineamento al compito, la coerenza fisica e 3D, la qualità del movimento, la coerenza temporale e la qualità visiva. Combinando verifiche tra le diverse visuali con misurazioni specifiche per ciascuna telecamera, il benchmark valuta se video plausibili presi singolarmente costituiscano anche una previsione coerente del compito previsto. Riassumiamo le prestazioni complessive con TWB-Score e manteniamo i risultati per ciascuna visuale, così da individuare i punti in cui le previsioni falliscono. Questo amplia la valutazione dei modelli del mondo, andando oltre la qualità visiva di una singola visuale. Codice, dati e definizioni delle metriche sono disponibili all’indirizzo https://github.com/TriWorldBench/TriWorldBench.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv