Ricerca
I transformer smettono di ragionare troppo presto, e una minuscola LoRA risolve il problema
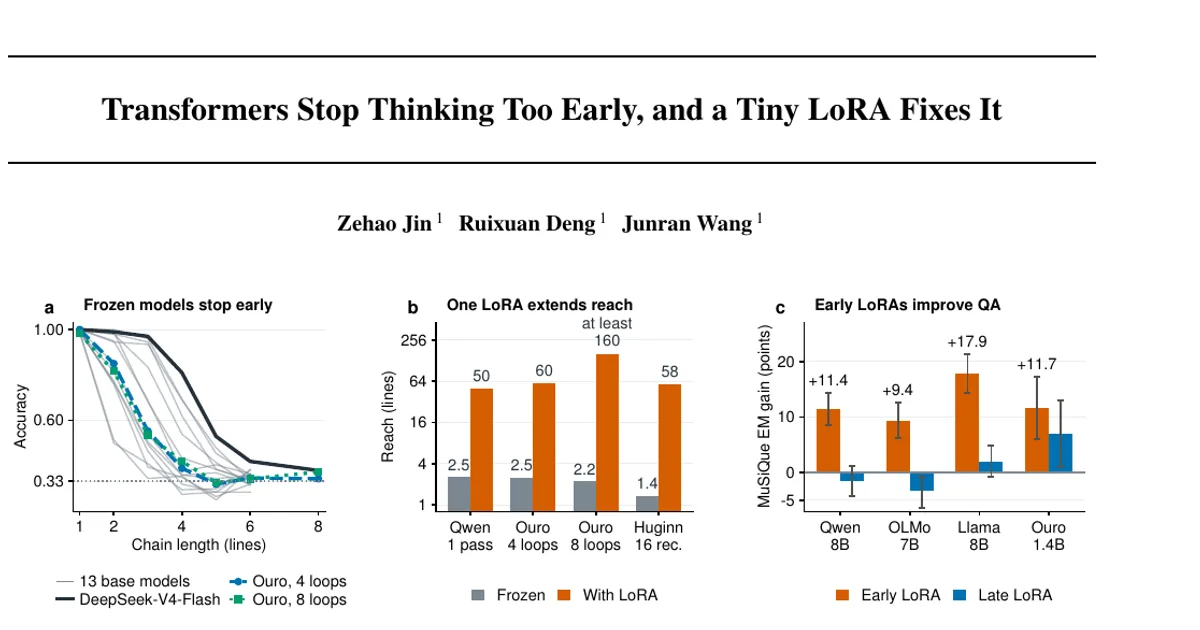
I transformer preaddestrati sfruttano solo una piccola parte della propria profondità per seguire i riferimenti nel contesto. Tredici modelli di base riescono a seguire in modo affidabile solo 1,4-3,6
- arXiv
- 2609.36585
- Pubblicato
- 2026-09-29
- Autori
- Zehao Jin, Ruixuan Deng, Junran Wang
Abstract degli autori
I transformer preaddestrati sfruttano solo una piccola parte della propria profondità per seguire i riferimenti nel contesto. Tredici modelli di base riescono a seguire in modo affidabile solo 1,4-3,6 righe, e i cicli preaddestrati aggiuntivi apportano pochi benefici. Una LoRA di rango 8 addestrata per il compito, applicata a un solo livello iniziale, estende questa elaborazione senza modificare alcun peso del modello. Qwen3-8B passa dal 15,5% al 99% di accuratezza esatta su catene di 24 righe; una LoRA addestrata più a lungo arriva a 50 righe. Ouro-1.4B arriva a 60 righe dopo quattro cicli e ad almeno 160 dopo otto. La LoRA avvia una staffetta: le righe del programma trasmettono la propria identità nella catena attraverso un breve intervallo di livelli intermedi. Le teste non modificate leggono via via più avanti nella catena, e la rimozione dell’attenzione alla riga madre interrompe la staffetta. Una misurazione effettuata sul modello non modificato individua, entro una certa tolleranza, l’ultimo livello su cui è utile intervenire in tre dei quattro modelli tenuti da parte. Le LoRA specifiche per il compito migliorano anche MuSiQue. Le risposte predefinite sottostimano quindi l’elaborazione accessibile con una modifica minuscola. Il codice e una demo interattiva sono disponibili all’indirizzo https://lunamos.github.io/stop-thinking-too-early/
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv