Ricerca
Verso una trascrizione corale che distingue le parti e assegna le voci cantate
La trascrizione automatica della musica (AMT) per singolo strumento ha compiuto notevoli progressi, ma nelle applicazioni corali soprano, contralto, tenore e basso (SATB) devono essere trascritti come
- arXiv
- 2610.09861
- Pubblicato
- 2026-10-07
- Autori
- Hanyu Meng, Zhanhong He, Zixun Guo, Yaolong Ju
Abstract degli autori
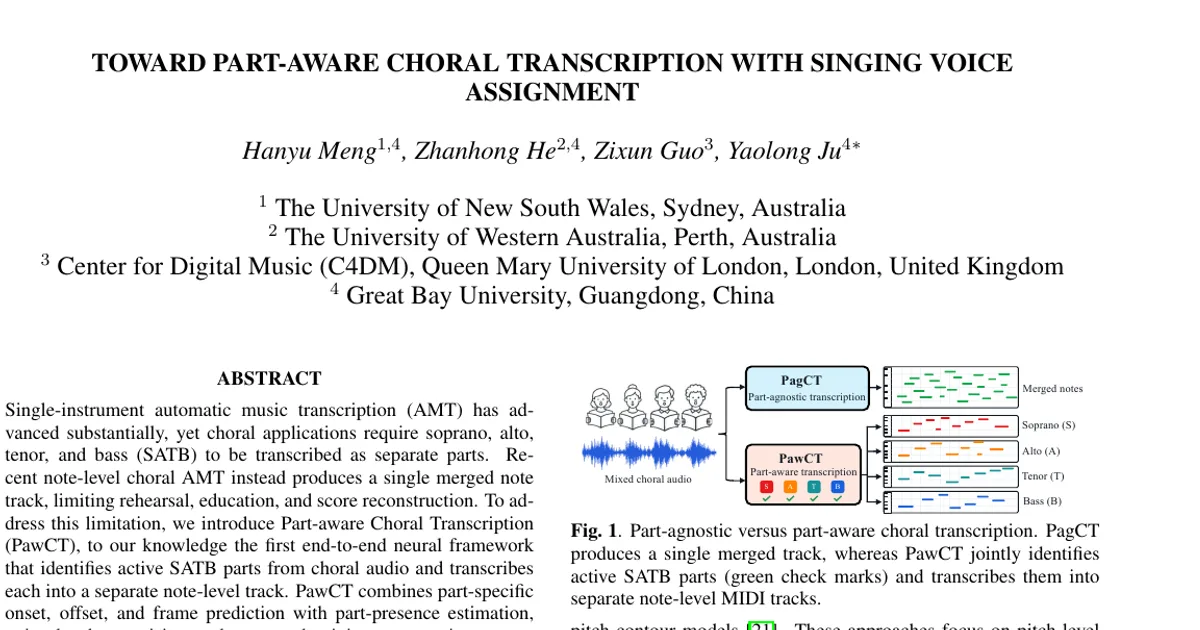
La trascrizione automatica della musica (AMT) per singolo strumento ha compiuto notevoli progressi, ma nelle applicazioni corali soprano, contralto, tenore e basso (SATB) devono essere trascritti come parti separate. I recenti sistemi di AMT corale a livello di nota producono invece un’unica traccia in cui confluiscono tutte le note, limitandone l’utilità per le prove, la didattica e la ricostruzione degli spartiti. Per superare questo limite, presentiamo Part-aware Choral Transcription (PawCT), a nostra conoscenza il primo sistema neurale end-to-end che identifica le parti SATB attive nell’audio corale e trascrive ciascuna in una traccia separata a livello di nota. PawCT combina la predizione di attacchi, conclusioni e frame per ciascuna parte con la stima della presenza delle parti, la supervisione a livello dell’insieme delle parti e obiettivi di addestramento strutturati. Questi ultimi impiegano un prior sull’estensione (RP), basato sulle estensioni vocali SATB, e la sua estensione di continuità ordinata (OC), che aggiunge la continuità melodica all’interno di ciascuna parte e l’ordinamento delle altezze tra le parti. Su YouChorale, PawCT-RP-OC raggiunge un F1 macro a livello di nota con distinzione delle parti pari a 0,225, con una tolleranza di 50 ms sugli attacchi: supera del 36,4% in termini relativi un modello corale di riferimento adattato (0,165) e ottiene un risultato superiore a quello di una pipeline in due fasi che assegna le parti a posteriori (0,175). La variante che non distingue le parti, PagCT, raggiunge un F1 sugli attacchi di 0,382 con una tolleranza di 50 ms, rispetto a 0,237 del precedente modello di AMT corale più avanzato. Valutazioni su altri dataset, CSD e Cantoria, esaminano inoltre le prestazioni quando cambiano i dati. Questi risultati mostrano il vantaggio di modellare congiuntamente la trascrizione delle note e l’assegnazione delle parti vocali. Il codice e le demo sono disponibili all’indirizzo https://hanyu-meng.github.io/Paw_Choral_AMT_Demo/.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv