Ricerca
ToolHACE: un dataset per rilevare le allucinazioni nelle risposte degli LLM basate su strumenti
I modelli linguistici che si avvalgono di strumenti fondano le proprie risposte sugli output di strumenti esterni, migliorando l’affidabilità rispetto al solo ricorso alle conoscenze parametriche. Tut
- arXiv
- 2610.17125
- Pubblicato
- 2026-10-12
- Autori
- Nikolay Ivanov, Sergey Pletenev, Elisei Rykov, Anatolii Frolov, Bogdan Monogov, Alexander Potekhin, Maria Marina, Daniil Moskovskiy, Viktor Moskvoretskii, Alexander Panchenko, Ilseyar Alimova
Abstract degli autori
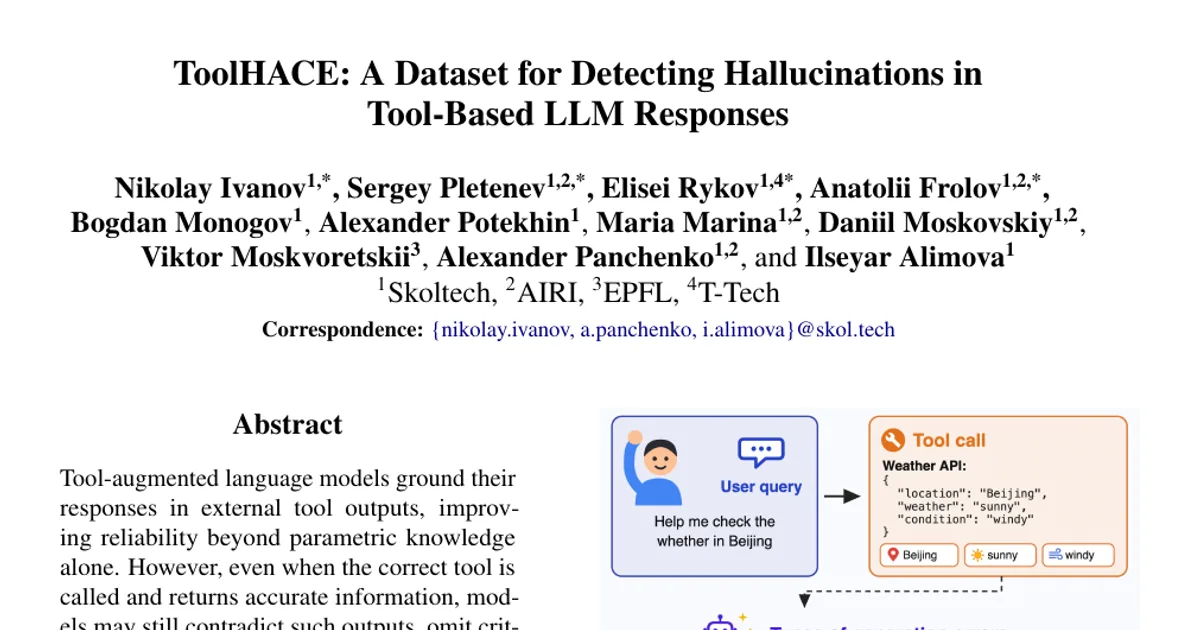
I modelli linguistici che si avvalgono di strumenti fondano le proprie risposte sugli output di strumenti esterni, migliorando l’affidabilità rispetto al solo ricorso alle conoscenze parametriche. Tuttavia, anche quando viene chiamato lo strumento corretto e questo restituisce informazioni accurate, i modelli possono contraddire tali output, omettere dettagli cruciali o formulare affermazioni prive di riscontro. I benchmark esistenti sulle allucinazioni nei dialoghi che impiegano strumenti si concentrano principalmente sulla fase di chiamata dello strumento, valutando se siano stati scelti lo strumento e gli argomenti corretti, ma trascurano gli errori che emergono quando viene generata la risposta dopo la chiamata. Per colmare questa lacuna, presentiamo ToolHACE, un benchmark che rileva le allucinazioni a livello di segmenti di testo nelle risposte degli LLM che si avvalgono di strumenti e comprende cinque categorie specifiche di allucinazioni. Attraverso ampi esperimenti con moderni sistemi di rilevamento delle allucinazioni, mostriamo che le allucinazioni successive alla chiamata dello strumento sono diffuse e restano difficili da rilevare. I nostri risultati dimostrano inoltre che un rilevamento efficace richiede l’addestramento su corpora specializzati che includano l’uso di strumenti, mentre il trasferimento da dataset sulle allucinazioni che non considerano gli strumenti dà scarsi risultati in questo contesto. Questi risultati evidenziano la necessità di benchmark e modelli dedicati per rilevare in modo affidabile le allucinazioni nei sistemi linguistici che si avvalgono di strumenti.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv