Ricerca
Agenti per il ragionamento sui dati efficienti nell’uso dei token grazie alla strutturazione adattiva dei dati non strutturati
Dati preziosi restano racchiusi in fonti non strutturate: pagine web, rapporti, contratti, documenti depositati, conferenze telefoniche sui risultati finanziari e PDF. La grande scommessa dell’IA azie
- arXiv
- 2608.31082
- Pubblicato
- 2026-08-31
- Autori
- Milad Rezaei Hajidehi, Qitong Wang, Stratos Idreos
Abstract degli autori
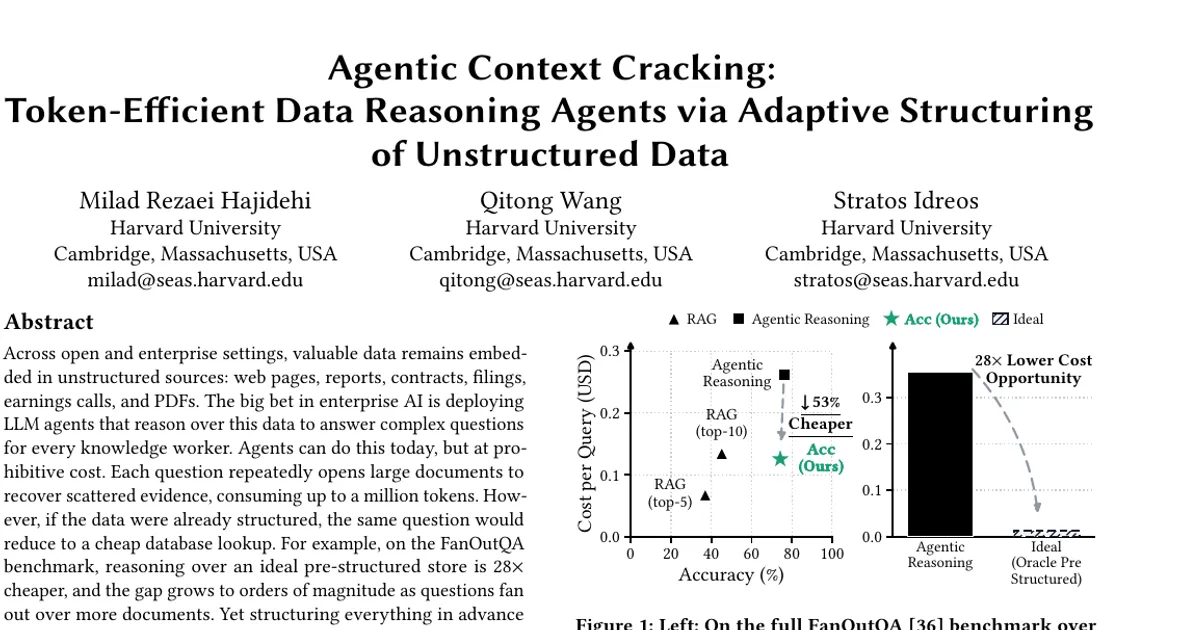
Dati preziosi restano racchiusi in fonti non strutturate: pagine web, rapporti, contratti, documenti depositati, conferenze telefoniche sui risultati finanziari e PDF. La grande scommessa dell’IA aziendale è impiegare agenti basati su LLM che ragionino su questi dati per rispondere a domande complesse di ogni lavoratore della conoscenza. Oggi gli agenti possono farlo, ma a costi proibitivi. Per ogni domanda, aprono ripetutamente documenti voluminosi per recuperare elementi di prova sparsi, consumando fino a un milione di token. Se però i dati fossero già strutturati, per rispondere alla stessa domanda basterebbe una consultazione poco costosa di un database. Per esempio, nel benchmark FanOutQA, ragionare su un archivio ideale già strutturato costa 28X meno, e il divario cresce fino a raggiungere ordini di grandezza quando le domande richiedono di consultare più documenti. Strutturare tutto in anticipo, tuttavia, non è praticabile: i documenti contengono molte più strutture possibili di quante ne userà un qualsiasi carico di lavoro, e non si sa quali strutture e quali documenti saranno utili finché non arrivano le query. Proponiamo *agentic data cracking*, un metodo che struttura i dati non strutturati in modo adattivo e speculativo come sottoprodotto del ragionamento stesso. La strutturazione è adattiva perché le query osservate determinano quando avviene e che cosa conta; è speculativa perché va oltre la domanda corrente. Ogni volta che l’agente apre un documento per rispondere, un sottoagente di cracking si dirama dal contesto già caricato, con un costo aggiuntivo marginale, ed estrae una struttura fondata sui dati che probabilmente servirà per future query correlate. Con il tempo, una quota crescente di query trova risposta interamente nei dati strutturati, senza che sia necessario aprire un documento, mantenendo l’accuratezza degli agenti a un costo vicino a quello di RAG. Su FanOutQA, esteso con una sola domanda correlata per ogni domanda del test, il cracking riduce i costi del 53% preservando l’accuratezza. *Agentic data cracking* è un primo passo verso un’infrastruttura di dati di nuova generazione per il ragionamento degli agenti sui dati non strutturati: un substrato condiviso sotto il modello, nel quale si accumula la conoscenza che è già costato ottenere attraverso il ragionamento.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv