Ricerca
TIM: modello di disaccoppiamento temporale con affinamento reciproco iterativo per la generazione di referti radiologici longitudinali
La generazione automatica di referti radiologici (RRG) mira a trasformare le immagini mediche in testi diagnostici, riducendo il carico di lavoro dei radiologi e uniformando la documentazione clinica.
- arXiv
- 2610.26271
- Pubblicato
- 2026-10-19
- Autori
- Yiheng Dong, Yi Lin, Shilong Huang, Xiyan Yang, Xin Yang
Abstract degli autori
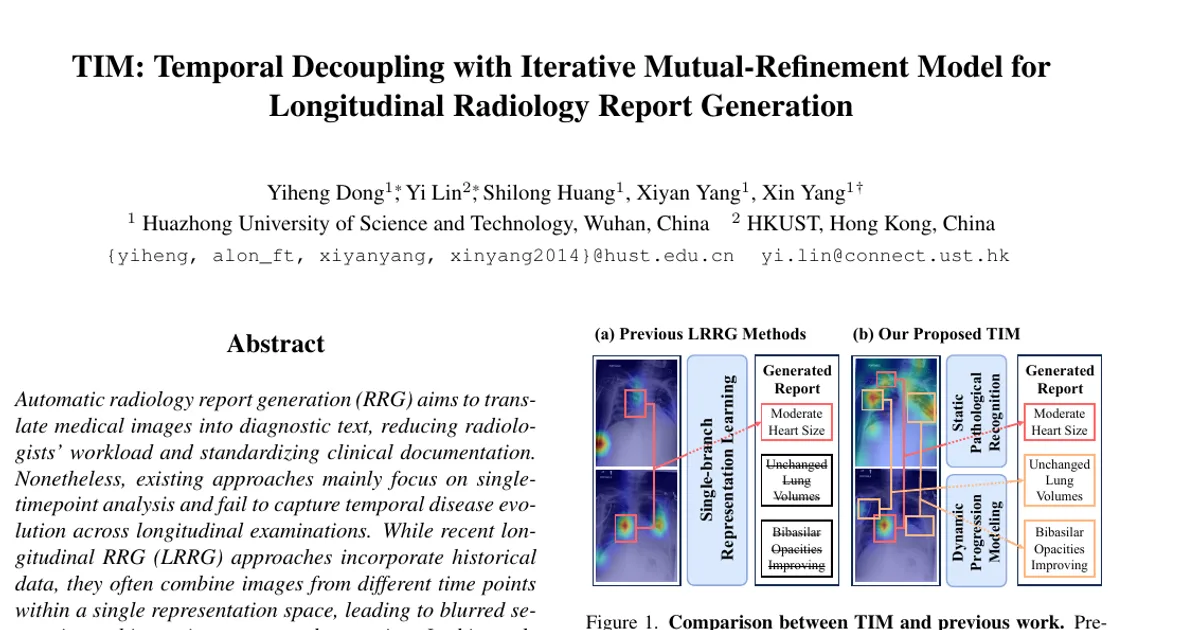
La generazione automatica di referti radiologici (RRG) mira a trasformare le immagini mediche in testi diagnostici, riducendo il carico di lavoro dei radiologi e uniformando la documentazione clinica. Tuttavia, gli approcci esistenti si concentrano soprattutto sull’analisi di un singolo momento e non riescono a cogliere l’evoluzione delle malattie nel tempo attraverso esami longitudinali. Sebbene gli approcci recenti alla generazione di referti radiologici longitudinali (LRRG) includano dati storici, spesso combinano immagini acquisite in momenti diversi in un unico spazio di rappresentazione, rendendo meno chiaro il significato delle rappresentazioni e incoerente il ragionamento temporale. In questo lavoro proponiamo Temporal Decoupling with Iterative Mutual-Refinement Model (TIM), un sistema in due fasi che separa esplicitamente la patologia sul piano spaziale dalla progressione temporale e affina iterativamente i referti attraverso un feedback reciproco. La fase I apprende rappresentazioni con disaccoppiamento temporale, separando i modelli di evoluzione nel tempo dalle caratteristiche specifiche delle malattie e generando referti radiologici sia per gli esami precedenti sia per quelli attuali. La fase II introduce un meccanismo di affinamento reciproco dei referti che individua le incoerenze diagnostiche nei referti precedenti e corregge iterativamente sia questi ultimi sia i referti attuali attraverso un feedback sensibile agli errori. Gli esperimenti sul dataset Longitudinal-MIMIC mostrano che TIM supera i baseline esistenti, sia quelli basati su una singola immagine sia quelli longitudinali, ottenendo nuove prestazioni allo stato dell’arte secondo metriche linguistiche e cliniche. Il codice è disponibile all’indirizzo https://github.com/yihengd/TIM.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv