Ricerca
Ragionare sulle inquadrature: modifica coerente di video con più inquadrature mediante ragionamento basato su agenti
Sebbene l’IA generativa abbia consentito notevoli progressi nella modifica dei video, i metodi esistenti si concentrano soprattutto su singole inquadrature o brevi clip. Modificare video lunghi seguen
- arXiv
- 2608.26809
- Pubblicato
- 2026-08-27
- Autori
- Chenyang Wu, Fuchen Long, Binyuan Huang, Xinlong Sun, Xi Chen, Chun-Le Guo, Chongyi Li
Abstract degli autori
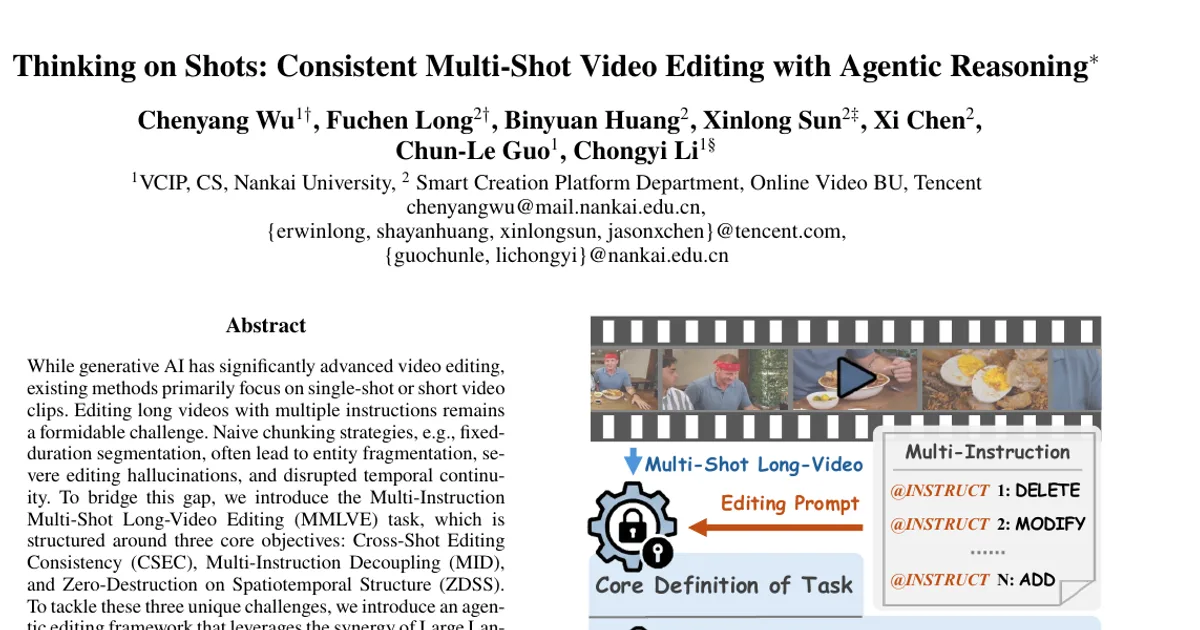
Sebbene l’IA generativa abbia consentito notevoli progressi nella modifica dei video, i metodi esistenti si concentrano soprattutto su singole inquadrature o brevi clip. Modificare video lunghi seguendo più istruzioni resta una sfida impegnativa. Le strategie semplicistiche di suddivisione in segmenti, per esempio a intervalli di durata fissa, spesso frammentano le entità, producono gravi allucinazioni nelle modifiche e interrompono la continuità temporale. Per colmare questa lacuna, introduciamo il compito Multi-Instruction Multi-Shot Long-Video Editing (MMLVE), articolato attorno a tre obiettivi fondamentali: coerenza delle modifiche tra inquadrature (CSEC), separazione delle diverse istruzioni (MID) e assenza di danni alla struttura spazio-temporale (ZDSS). Per affrontare queste tre sfide specifiche, presentiamo un sistema di modifica basato su agenti che sfrutta la sinergia tra modelli linguistici di grandi dimensioni (LLM) e modelli visivo-linguistici (VLM) per separare il video a livello di inquadratura e interpretare con precisione le istruzioni. Per valutare in modo esaustivo questo compito, realizziamo inoltre MMLVE-Bench, un dataset dedicato a MMLVE caratterizzato da complesse dinamiche spazio-temporali del mondo reale, un’elevata densità di istruzioni eterogenee e distribuzioni sparse e casuali delle entità. Impieghiamo anche tre metriche di valutazione specifiche per MMLVE per misurare la qualità dei risultati delle modifiche. Esperimenti approfonditi dimostrano che il nostro MMLVE-Agent supera gli approcci allo stato dell’arte a codice chiuso, come Seedance 2.0, eliminando le allucinazioni nelle modifiche, preservando la coerenza delle modifiche tra inquadrature e ottenendo transizioni spazio-temporali fluide.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv