Ricerca
Pensare come un modello del mondo, agire come un VLA: distillare le rappresentazioni dei modelli del mondo in policy robotiche compatte
I modelli Vision-Language-Action (VLA) associano osservazioni ad azioni senza una funzione obiettivo che tenga conto di come reagisce il mondo. La loro robustezza è quindi limitata soprattutto dalla c
- arXiv
- 2609.24682
- Pubblicato
- 2026-09-21
- Autori
- Trung Dao, Sankalp Yamsani, Jaden Park, Joohyung Kim, Yong Jae Lee
Abstract degli autori
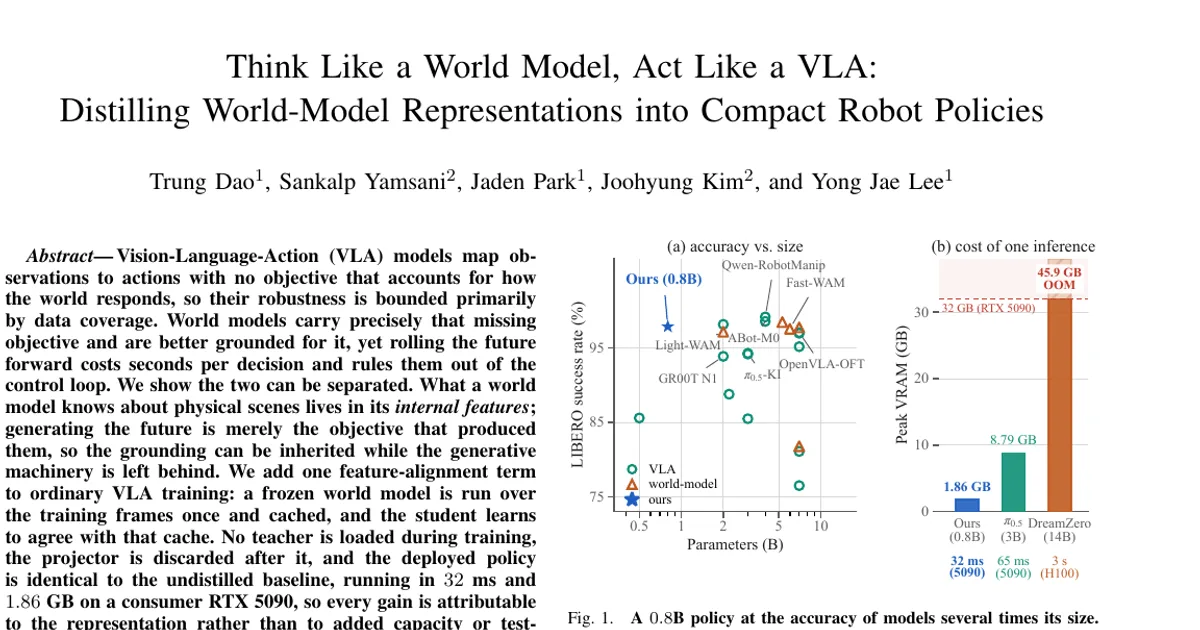
I modelli Vision-Language-Action (VLA) associano osservazioni ad azioni senza una funzione obiettivo che tenga conto di come reagisce il mondo. La loro robustezza è quindi limitata soprattutto dalla copertura dei dati. I modelli del mondo hanno proprio la funzione obiettivo che manca ai VLA e, per questo, sono meglio ancorati alla realtà; simulare l’evoluzione futura, però, richiede secondi per ogni decisione e li esclude dal ciclo di controllo. Mostriamo che le due cose possono essere separate. Ciò che un modello del mondo sa delle scene fisiche risiede nelle sue feature interne; generare il futuro è soltanto la funzione obiettivo che le ha prodotte. È quindi possibile ereditarne l’ancoraggio alla realtà senza portarsi dietro l’apparato generativo. Aggiungiamo un solo termine di allineamento delle feature al normale addestramento VLA: eseguiamo una volta un modello del mondo congelato sui frame di addestramento, memorizziamo nella cache le feature che produce e addestriamo il modello studente ad allinearsi a esse. Durante l’addestramento non viene caricato alcun modello insegnante, il proiettore viene eliminato al termine e la policy impiegata è identica alla baseline non distillata: su una RTX5090 di fascia consumer funziona in 32 ms e occupa 1,86 GB. Ogni miglioramento è quindi attribuibile alla rappresentazione, non a una maggiore capacità o a calcoli aggiuntivi durante l’uso. Un modello studente da 0,8 miliardi di parametri raggiunge il 97,9% su LIBERO, passa dal 48,2% al 50,5% nella manipolazione umanoide su RoboCasa-GR1 e la stessa funzione obiettivo si applica anche all’hardware reale, sia su una piattaforma a un solo braccio sia su una bimanuale. Il miglioramento persiste al variare delle dimensioni del modello studente, del backbone, del livello di allineamento e del modello insegnante: ciò indica un prior rappresentazionale di ampia portata, anziché un allineamento fragile tra due reti specifiche. Pagina del progetto: https://thaw-vla.trung-dt.com/.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv