Ricerca
System1-Arena: quali decisioni si possono affidare a System 1?
I modelli linguistici di grandi dimensioni (LLM) prendono spesso decisioni discrete, per esempio segnalare un tentativo di phishing o affidare un caso a una persona. I modelli System-1, come Jev e Ope
- arXiv
- 2610.21244
- Pubblicato
- 2026-10-15
- Autori
- Tianyu Chen, Xinyang Liu, Ruyi An, Zhendong Wang, Mingyuan Zhou
Abstract degli autori
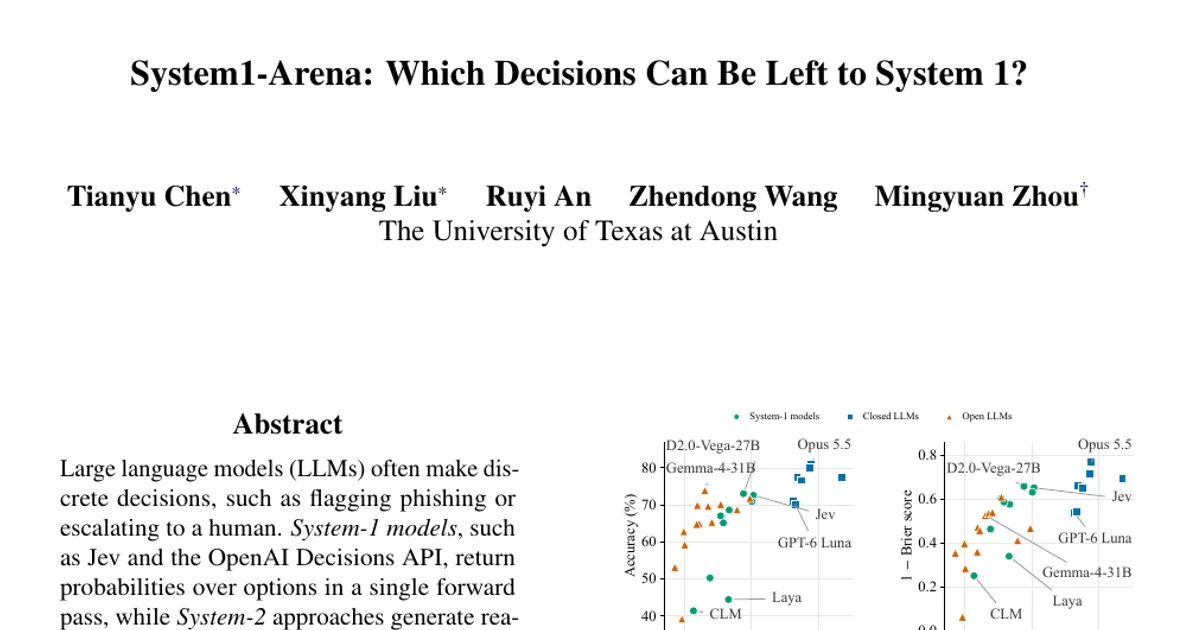
I modelli linguistici di grandi dimensioni (LLM) prendono spesso decisioni discrete, per esempio segnalare un tentativo di phishing o affidare un caso a una persona. I modelli System-1, come Jev e OpenAI Decisions API, restituiscono le probabilità delle diverse opzioni in un solo passaggio di calcolo, mentre gli approcci System-2 generano passaggi di ragionamento. Quali decisioni possono gestire i modelli System-1 e quali richiedono un ragionamento generativo? Presentiamo System1-Arena, un benchmark che sottopone a tutti i modelli le stesse richieste decisionali e valuta le probabilità che assegnano. Comprende 92mila domande relative a 105 compiti, tratte da 268 fonti pubbliche e suddivise in quattro gruppi: classificazione del testo e conoscenza, decisioni applicate, valutazione e controllo, agenti e azioni. Include inoltre 138 ambienti a ciclo chiuso, dagli acquisti online e dal controllo della programmazione su SWE-bench alla robotica, ai giochi e alla guida; nella modalità in tempo reale, il mondo evolve mentre un modello decide. Valutiamo 30 modelli: 7 LLM chiusi, 13 LLM aperti le cui probabilità vengono lette al token della risposta e 10 modelli System-1. I modelli System-1 più grandi eguagliano o superano gli LLM chiusi veloci per accuratezza nei compiti che non coinvolgono agenti, con probabilità meglio calibrate e una latenza pari a un quarto. Un LLM di ragionamento è il più accurato, a un costo pari a circa 70 volte quello di un LLM veloce. Negli ambienti a ciclo chiuso, gli LLM aperti di grandi dimensioni ottengono i risultati migliori più spesso (fino al 32,9%); i modelli System-1 piccoli riescono raramente a completare i compiti.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv