Ricerca
SyncReward: una ricompensa per la sincronizzazione audio-video allineata al giudizio umano
Negli ultimi anni, la generazione congiunta di audio e video ha compiuto rapidi progressi. La sincronizzazione audio-video resta però una sfida: il parlato e i suoni generati spesso non coincidono tem
- arXiv
- 2610.16338
- Pubblicato
- 2026-10-12
- Autori
- Kaisi Guan, Ying Ba, Wenjing Wang, Xihua Wang, Chen Li, Jing Lyu, Ruihau Song
Abstract degli autori
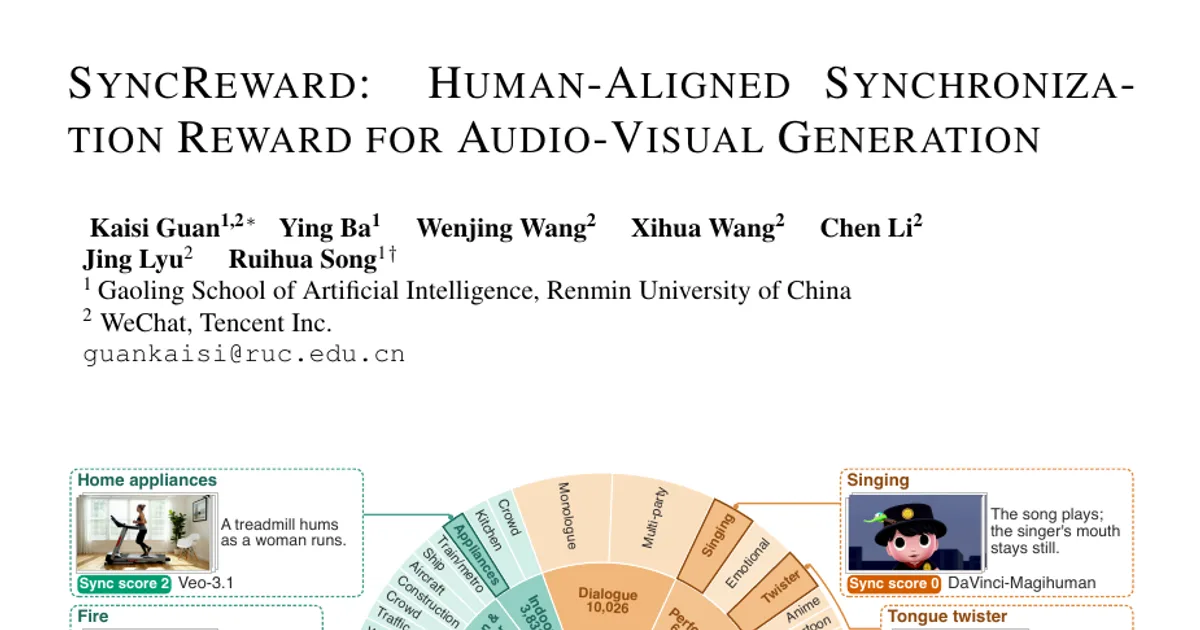
Negli ultimi anni, la generazione congiunta di audio e video ha compiuto rapidi progressi. La sincronizzazione audio-video resta però una sfida: il parlato e i suoni generati spesso non coincidono temporalmente con gli eventi visivi. Un ostacolo fondamentale è la mancanza di dati annotati da esseri umani, di benchmark di valutazione affidabili e di modelli di valutazione sensibili alla sincronizzazione per gli output audio-video generati. Per affrontare questi limiti, conduciamo uno studio approfondito su dati, benchmark e modelli di ricompensa. Presentiamo anzitutto SyncReward-Data-80K, un dataset che contiene 80K valutazioni professionali della sincronizzazione di clip provenienti da otto generatori audio-video. Un processo di costruzione guidato da una tassonomia copre quattro famiglie di eventi sonori: parlato, attacchi sonori, strumenti e suoni ambientali. Costruiamo inoltre \textbf{SyncReward-Bench}, un benchmark separato di 1K clip, ciascuna valutata in modo indipendente da più professionisti. Usando questo benchmark, valutiamo sistematicamente metriche specializzate per la sincronizzazione e modelli omnimodali, rilevando una notevole discrepanza rispetto ai giudizi umani. Infine, sviluppiamo SyncReward, un modello di ricompensa che combina il preaddestramento contrastivo semantico-temporale su clip reali con la supervisione umana su clip generate. Come metrica di valutazione, SyncReward ottiene la maggiore concordanza con le valutazioni umane tra i metodi esaminati. Come segnale di ricompensa, migliora la sincronizzazione attraverso la selezione del migliore tra $N$ risultati in fase di inferenza e il post-addestramento basato sull’apprendimento per rinforzo. Renderemo disponibili i dati, il benchmark, il modello e il codice all’indirizzo https://github.com/WeChatCV/SyncReward.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv