Ricerca
Stiamo valutando troppo? Una rassegna sulla compressione dei benchmark per valutare in modo efficiente i modelli linguistici di grandi dimensioni
I benchmark sono essenziali per valutare e migliorare i modelli linguistici di grandi dimensioni (LLM). Eppure molti benchmark ampiamente utilizzati sono ridondanti e rendono la valutazione inutilment
- arXiv
- 2610.18248
- Pubblicato
- 2026-10-13
- Autori
- Guoming Ling, Yupei Lin, Zhongzhan Huang, Junxin Li, Junjie Liu, Shanshan Zhong, Hefeng Wu, Liang Lin
Abstract degli autori
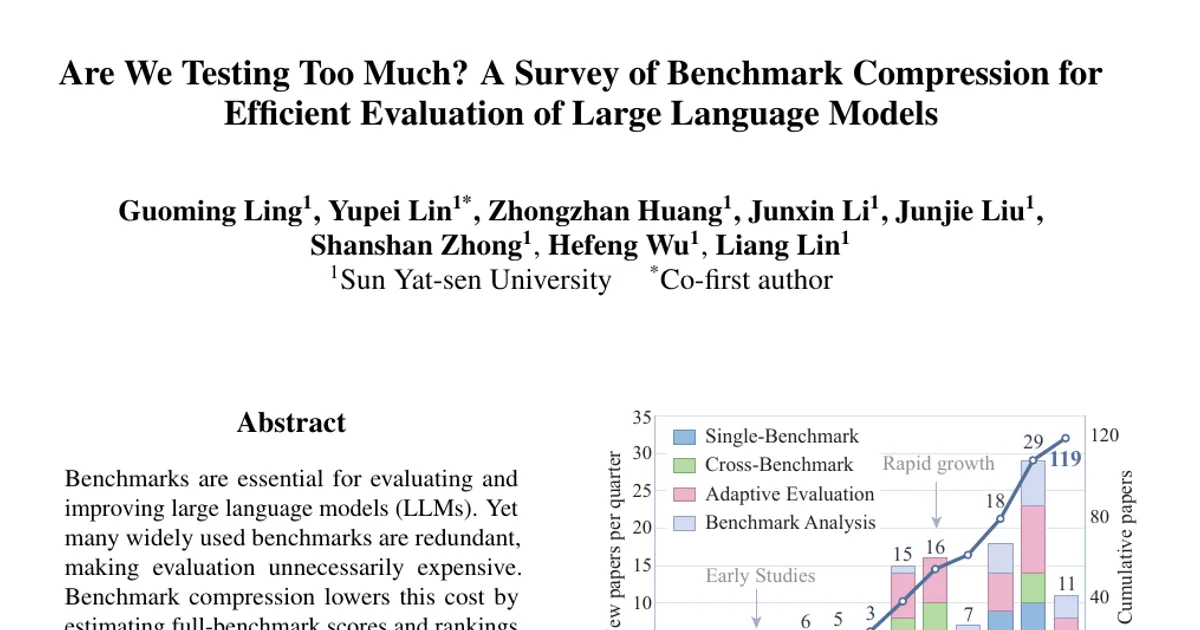
I benchmark sono essenziali per valutare e migliorare i modelli linguistici di grandi dimensioni (LLM). Eppure molti benchmark ampiamente utilizzati sono ridondanti e rendono la valutazione inutilmente costosa. La compressione dei benchmark riduce questo costo stimando i punteggi e le classifiche dell’intero benchmark a partire da una valutazione parziale. La ricerca in questo ambito è cresciuta rapidamente dal 2024, ma, per quanto ne sappiamo, nessuna rassegna ne ha organizzato sistematicamente i metodi e i risultati. Esaminiamo 119 articoli per spiegare come i metodi scelgono cosa valutare, ricostruiscono i risultati dell’intero benchmark e ne verificano l’affidabilità. Da questa analisi sviluppiamo una tassonomia che comprende la compressione all’interno dei singoli benchmark, tra suite di benchmark e durante la valutazione adattiva, insieme agli studi sulla ridondanza e sull’affidabilità. Confrontiamo il loro fabbisogno di informazioni, i costi complessivi, le verifiche dell’affidabilità e i limiti. I metodi riducono i costi di valutazione selezionando sottoinsiemi rappresentativi, usando informazioni meno costose o riutilizzabili e svolgendo test in modo adattivo, ma comportano il rischio di una copertura insufficiente, stime imprecise e ritardi dovuti alla sequenzialità. La tassonomia e la guida pratica che ne derivano aiutano i ricercatori a scegliere, convalidare e impiegare metodi per valutare gli LLM in modo più efficiente e affidabile.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv