Ricerca
Il disapprendimento della policy basato su feature sparse attenua l’allucinazione dello stato nei modelli visione-linguaggio-azione
I modelli visione-linguaggio-azione (VLA) hanno mostrato una forte capacità di generalizzazione nella manipolazione robotica grazie alle ricche rappresentazioni dei modelli visione-linguaggio preaddes
- arXiv
- 2610.09496
- Pubblicato
- 2026-10-07
- Autori
- Jiho Lee, Jeongeun Park, Heayoun Choi, Taekyung Kim, Eunwoo Kim
Abstract degli autori
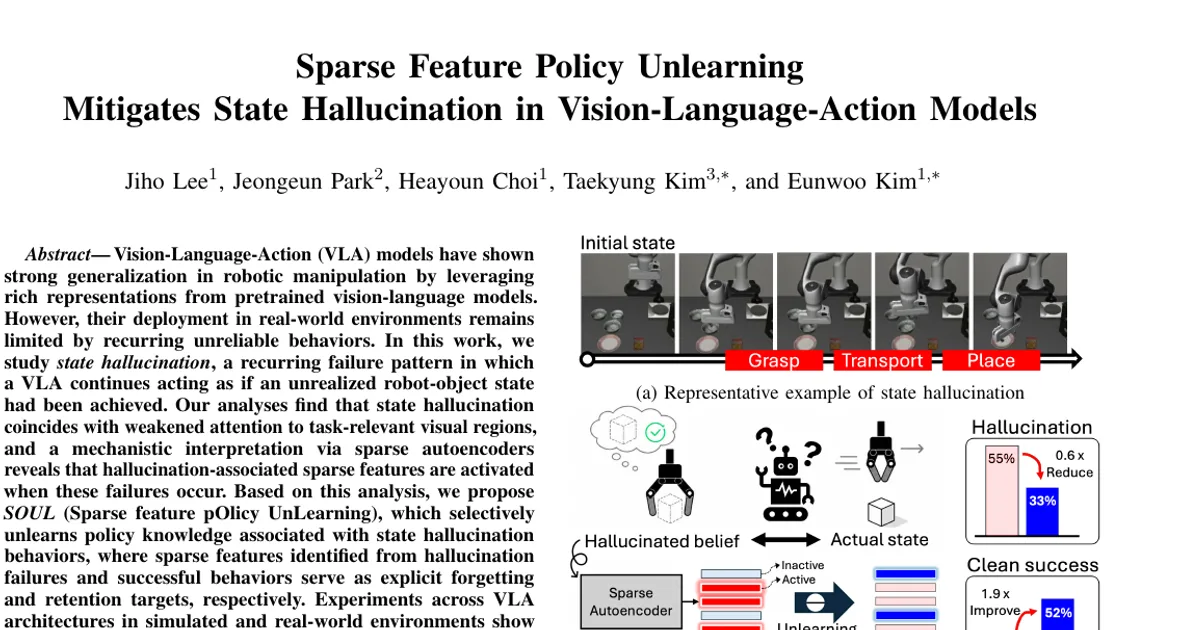
I modelli visione-linguaggio-azione (VLA) hanno mostrato una forte capacità di generalizzazione nella manipolazione robotica grazie alle ricche rappresentazioni dei modelli visione-linguaggio preaddestrati. Il loro impiego in ambienti reali resta però limitato da comportamenti inaffidabili ricorrenti. In questo lavoro studiamo l’allucinazione dello stato, uno schema di errore ricorrente in cui un modello VLA continua ad agire come se fosse stato raggiunto uno stato del robot e dell’oggetto che in realtà non si è verificato. Le nostre analisi mostrano che l’allucinazione dello stato coincide con un’attenzione ridotta alle regioni visive rilevanti per il compito; un’interpretazione dei meccanismi interni mediante autoencoder sparsi rivela inoltre che, quando si verificano questi errori, si attivano feature sparse associate all’allucinazione. Sulla base di questa analisi proponiamo SOUL (Sparse feature pOlicy UnLearning), un metodo che fa disapprendere selettivamente alla policy le conoscenze associate ai comportamenti di allucinazione dello stato. Le feature sparse individuate rispettivamente negli errori dovuti all’allucinazione e nei comportamenti riusciti costituiscono obiettivi espliciti di disapprendimento e conservazione. Esperimenti condotti su diverse architetture VLA, in ambienti simulati e reali, mostrano che il nostro metodo riduce sostanzialmente gli errori dovuti all’allucinazione e migliora il successo nei compiti senza compromettere in misura sostanziale le capacità di manipolazione già presenti. Questi risultati suggeriscono che l’analisi di feature interpretabili offre una base pratica per modificare selettivamente le conoscenze indesiderate nelle policy robotiche.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv