Ricerca
SlideDP: fine-tuning degli LLM con parametri residenti sull’host su più GPU
Lo streaming dei livelli residenti sull’host consente il fine-tuning di tutti i parametri degli LLM anche quando non entrano nella memoria delle GPU, ma i processi paralleli sui dati competono per le
- arXiv
- 2609.34162
- Pubblicato
- 2026-09-28
- Autori
- Ruijia Yang, Shiyuan Lin, Yulong Ao, Zhiyu Li, Yingli Zhao, Xianduo Li, Yonghua Lin, Zeyi Wen
Abstract degli autori
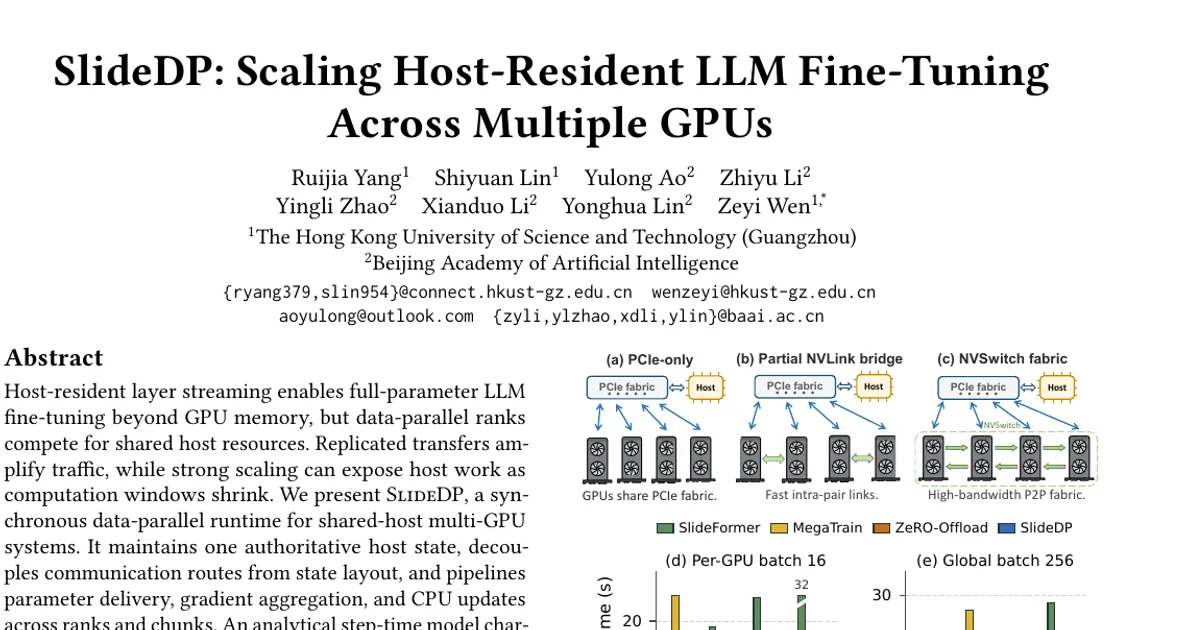
Lo streaming dei livelli residenti sull’host consente il fine-tuning di tutti i parametri degli LLM anche quando non entrano nella memoria delle GPU, ma i processi paralleli sui dati competono per le risorse condivise dell’host. I trasferimenti replicati aumentano il traffico, mentre, con lo scaling forte, il lavoro dell’host può diventare più evidente man mano che si riducono gli intervalli dedicati al calcolo. Presentiamo SlideDP, un sistema di esecuzione sincrono con parallelismo sui dati per sistemi multi-GPU con host condiviso. Mantiene un unico stato autorevole sull’host, separa i percorsi di comunicazione dalla disposizione dello stato e organizza in pipeline la distribuzione dei parametri, l’aggregazione dei gradienti e gli aggiornamenti sulla CPU tra processi e blocchi. Un modello analitico del tempo per passo caratterizza i colli di bottiglia delle risorse e l’esposizione della pipeline; le misurazioni durante l’esecuzione guidano le politiche di comunicazione, suddivisione in blocchi e gestione delle attivazioni entro un limite di memoria delle GPU. In serie di test con batch di pari dimensione, SlideDP raggiunge rapporti di throughput, calcolati come media geometrica, compresi tra 1,46 e 2,64$\times$ rispetto a SlideFormer, MegaTrain e ZeRO-Offload. Su quattro H100, SlideDP si avvicina al throughput di FSDP2 con parametri residenti sulle GPU per Qwen3-14B, con un batch più piccolo. Con un batch più grande, elabora oltre 1M token per passo e supera dell’11,2% il picco di throughput misurato di FSDP2. Separatamente, supporta sequenze da 256K token per lo stesso modello ed esegue il fine-tuning di Qwen2.5-72B su quattro GPU RTX 4090. Pagina del progetto: https://github.com/RegiaYoung/SlideDP.
Il riassunto di questo paper è disponibile solo in inglese: leggilo nella pagina inglese.
Leggi il paper originale su arXiv